Recentemente, fizemos uma postagem sobre tokenomics e ataques de “negação de carteira” (denial of wallet): um novo tipo de ataque DDoS que busca gerar gastos excessivos com tokens de IA. Antes de começarem a proteger os processos de IA de seus colegas contra essa nova ameaça, os profissionais de segurança precisam considerar que as próprias atividades do departamento de segurança da informação também podem ser alvo desse tipo de ataque. Como as equipes de segurança estão testando e implementando ativamente diferentes formas de automação baseada em IA, a ameaça de interferência externa destinada a paralisar o sistema de defesa pode afetar diretamente seus próprios processos e tecnologias.
A Elastic estima que, conforme a arquitetura do SOC baseado em agentes, a triagem de um único alerta de um host pode custar US$ 0,69 com um conjunto de agentes especializados ou US$ 3,42 com um agente de uso geral capaz de executar 14 tipos diferentes de tarefas.
No entanto, esses valores médios ocultam uma enorme variação nos custos. A qualquer momento, o processamento inicial de um alerta simples (como, por exemplo, mil tokens) pode desencadear uma investigação sobre o processamento de milhões de entradas de registro, chamadas de API, e de outros dados relacionados, consumindo milhões de tokens em questão de minutos.
A própria Elastic reconhece que utiliza o modelo Claude Sonnet 4.6 em seu SOC. Isso levanta uma questão imediata: o que acontece quando o orçamento se esgota ou os filtros de segurança do modelo são acionados? No pior cenário, o SOC baseado em IA aciona uma “orquestra de agentes” para investigar eventos suspeitos que se assemelham a movimentos laterais na infraestrutura. O agente faz uma chamada à API da Anthropic, mas o orçamento mensal do departamento já se esgotou, e a API retorna erros. A investigação fica paralisada, e a equipe só percebe o problema meio dia depois. Além disso, se os “filtros de segurança” de um grande provedor de IA, que estão em constante mudança, classificarem as solicitações do SOC como maliciosas, o mesmo poderá ocorrer mesmo que ainda haja orçamento disponível. Isso ficou evidente na experiência da Hugging Face ao investigar a invasão de sua infraestrutura pela OpenAI.
É claro que um invasor tem interesse em provocar esse tipo de situação. O invasor pode aumentar diretamente os custos da equipe de defesa ao inserir prompts maliciosos nos dados que ela processa, como registros DNS TXT, cabeçalhos HTTP, comentários no código e nomes de arquivos, sabendo que esses prompts serão analisados pelos sistemas de segurança da informação. No ataque GhostJacking, registros do WAF são usados como vetor para a injeção de prompts. Em outro método, apresentado em um estudo acadêmico, pesquisadores conseguiram atacar as própriasproteções de segurança dos LLMs, aumentando a latência das solicitações em 148 vezes e o consumo de tokens em 63 vezes. Em teoria, o sistema continua funcionando normalmente, mas o processamento dos alertas fica muito mais lento e os custos associados aumentam significativamente.
O perigo das falhas silenciosas
Em sistemas baseados em agentes, o esgotamento do orçamento nem sempre gera um erro explícito com a mensagem “limite de solicitações excedido” e um alerta imediato aos responsáveis. Em determinadas configurações, pode ocorrer degradação silenciosa: quando uma solicitação ao modelo excede o tempo limite, o sistema muda automaticamente para um modelo mais barato, reduzindo a qualidade das respostas e interrompendo a execução de subagentes e tarefas periódicas. Enquanto isso, a equipe de segurança pode passar horas acreditando que tudo continua funcionando normalmente.
Como controlar os custos da IA na cibersegurança
Gerenciar os custos, é claro, não se resume a “evitar gastos excessivos”. O setor já caiu nessa armadilha ao implementar soluções SIEM: quando as empresas passaram a pagar de acordo com o volume de telemetria coletada, começaram a restringir seletivamente a coleta de registros, nem sempre de forma eficaz. Como resultado, surgiram pontos cegos na detecção de ameaças. O mesmo pode acontecer com os tokens, mas de forma mais rápida e em maior escala. Uma política de redução de custos mal planejada pode comprometer a profundidade das investigações e a qualidade das respostas. Sem uma política desse tipo, a decisão sobre o que cortar ficará a cargo do analista de plantão às 3h da manhã, e não do arquiteto ou do CISO durante a fase de projeto do sistema. Outra possibilidade é que o próprio fornecedor do sistema imponha limites automaticamente.
Alguns princípios simples ajudam a evitar aumentos previsíveis de custos e a gerenciar melhor situações realmente imprevisíveis.
Não recorra à IA para analisar informações que podem ser verificadas por meio de consultas convencionais. Tarefas repetitivas e previsíveis devem continuar sendo executadas da maneira tradicional, com regras e consultas a dados. Essas regras e consultas podem ser desenvolvidas com o auxílio da IA, mas devem funcionar de maneira determinística. O modelo deve ser usado apenas quando for realmente necessário avaliar uma situação ambígua.
Estabeleça limites rigorosos e emita alertas imediatos aos usuários sempre que forem ultrapassados. Combine diferentes tipos de limite, como limites por tarefa, limites diários e assim por diante. Os alertas de violação dos limites devem chegar imediatamente tanto aos analistas de plantão quanto aos responsáveis por todo o sistema.
Defina com antecedência o que fazer quando um limite for atingido. A decisão entre interromper o processo para economizar, mesmo que isso reduza o controle, ou continuar e arcar com os custos deve ser tomada antes que ocorra um incidente.
Restrinja as permissões dos agentes e as ferramentas às quais eles têm acesso. Quanto mais restrito o conjunto de ações, melhor será seu desempenho em tarefas específicas. Isso também reduz as oportunidades de elevar os custos e a probabilidade de exploração por agentes externos.
Examine rigorosamente os dados externos não confiáveis. Solicitações, consultas, mensagens, comentários e campos técnicos de texto livre, como registros DNS, cabeçalhos HTTP e nomes de arquivos, podem servir tanto para injetar prompts maliciosos quanto para sobrecarregar deliberadamente o sistema. Limite o tamanho desses dados e monitore a carga de trabalho que geram.
Para evitar interrupções causadas por provedores externos e manter o controle total sobre os dados da organização, avalie a possibilidade de usar modelos locais implantados na própria infraestrutura, pelo menos nas atividades de segurança da informação. Embora não sejam os modelos mais avançados, sua especialização e seu ajuste fino com dados da empresa podem garantir bom desempenho e reduzir o risco de falhas inesperadas.
Em arquiteturas mais complexas, os LLMs podem ser divididos em níveis de gravidade. A primeira linha de defesa, responsável por roteamento, filtragem de ruído e enriquecimento de dados é tratada localmente por modelos compactos. Isso reduz significativamente a imprevisibilidade dos custos. O segundo nível conta com um modelo local de maior porte, responsável pelo trabalho analítico principal: correlacionar eventos, testar hipóteses e reconstruir o cenário do incidente. Esse modelo também não gera custos por solicitação, mas tem capacidade limitada, o que pode causar gastos além do orçamento, sobrecargas e acúmulo de eventos em filas. Apenas casos excepcionais e realmente complexos são encaminhados a modelos avançados na nuvem, de preferência com a aprovação explícita de um analista. Nesse modelo, ainda há custos variáveis, mas eles ficam restritos a poucos casos. Cada encaminhamento é uma decisão consciente, e não uma consequência inesperada de um script executado durante a noite.
Na prática, essa abordagem reproduz o modelo clássico de SOC em vários níveis: a primeira linha faz a triagem, e a terceira conduz as investigações. A diferença é que essas funções são desempenhadas por modelos, e não por pessoas.
Há pouco tempo, muitas empresas começaram a implementar agentes de IA em uma ampla variedade de fluxos de trabalho. Rapidamente, o custo de uso desses agentes se tornou uma questão urgente para as empresas. Além disso, a questão vai muito além do departamento financeiro. Além das preocupações orçamentárias, surgiram problemas de confiabilidade, estabilidade operacional e até de segurança da informação. Isso ocorre porque o custo de automatizar um mesmo processo varia significativamente entre implementações, é imprevisível e pode ser afetado por fatores externos.
Além disso, para um agente malicioso, qualquer processo automatizado com IA e vulnerável a influências externas é, na prática, um alvo conveniente para o “novo tipo de ataque DDoS”. Relatórios de erros de aplicativos, avaliações de produtos ou solicitações de suporte técnico podem, assim como qualquer outro dado externo processado pela empresa com IA, ser usados em um ataque para aumentar o consumo de tokens (fragmentos de palavras que são a unidade básica de entrada e saída de um LLM).
Um ano de crescimento explosivo… nas contas
Em 2026, grandes empresas gastaram pela primeira vez muito além do orçamento destinado a seus sistemas de IA. A Uber já havia gasto todo o orçamento anual até abril, enquanto uma empresa não identificada não definiu limites de gastos para o Claude e gastou US$ 500 milhões em um único mês. Embora os provedores de IA anunciem regularmente preços mais baixos e modelos mais eficientes, a transição de chatbots para sistemas agênticos que operam de forma contínua e autônoma aumenta o consumo de tokens em centenas ou milhares de vezes. Ao mesmo tempo, o modelo de “assinatura fixa de US$ 20 ou US$ 100” para empresas é coisa do passado. Todos os principais provedores estão migrando clientes corporativos para o modelo de pagamento conforme o uso.
Como resultado, as empresas estão enfrentando um problema já conhecido pelos setores de armazenamento em nuvem e telecomunicações. Sem sistemas especializados de contabilização e gerenciamento de custos, uma organização só descobre quanto um determinado processo ou projeto custou depois de concluí-lo. Nos setores de telecomunicações e nuvem, esse problema acabou sendo resolvido com o desenvolvimento de sistemas sofisticados de faturamento, e os clientes desses setores até adotaram o termo especializado FinOps. No caso da IA, esse processo ainda está em estágio inicial. Além disso, a natureza probabilística da IA generativa torna esse problema ainda mais difícil de resolver.
Consumo imprevisível de tokens
Para entender por que os custos aumentam tão rapidamente e são tão difíceis de prever e controlar, precisamos lembrar como funciona um modelo de linguagem e o que o transforma em um agente de IA. O modelo não armazena informações de estado. Em outras palavras, não retém informações entre as interações. A cada nova etapa, todo o histórico de trabalho de uma determinada tarefa (o contexto) precisa ser reenviado ao modelo: o prompt inicial, o raciocínio anterior, o conteúdo dos arquivos lidos e as respostas de todas as ferramentas. A cada etapa, essa “recapitulação” fica mais longa, especialmente se a tarefa envolver loops iterativos. Se uma etapa falhar, a resposta não for clara ou uma ferramenta retornar um erro, o agente simplesmente tenta novamente, aumentando ainda mais o tamanho do contexto. E, se a tarefa for executada por vários agentes, que dividem o trabalho entre si e trocam resultados, esse volume aumenta proporcionalmente ao número de agentes. Como resultado, o consumo de tokens não aumenta gradualmente, mas em saltos, e é quase impossível prevê-lo no início da tarefa.
Ao executar duas sessões diferentes de um agente de IA para resolver exatamente a mesma tarefa (dois tíquetes de suporte técnico, duas tarefas de análise e assim por diante), a quantidade de tokens consumidos pode variar. A diferença pode chegar a 30 (!) vezes. Isso depende do número de etapas, erros e tentativas necessárias para concluir a tarefa. O aumento do consumo de recursos não depende necessariamente da complexidade da tarefa. Há casos conhecidos em que a IA ficou presa em um “loop de raciocínio” e desperdiçou uma quantidade absurda de recursos em tarefas triviais.
Três gerações de IA em sistemas corporativos consomem recursos de maneiras completamente diferentes:
Machine learning clássico (ML). Normalmente, trabalha com dados bem estruturados e não exige muitos recursos computacionais. O consumo de recursos é previsível e baixo. É um item de orçamento fixo;
Um chatbot ou outro assistente de IA baseado em LLM. Ele consome tokens, mas o ritmo é definido por uma pessoa: o funcionário inicia a tarefa manualmente, avalia o resultado e interrompe o processo. O custo aumenta aproximadamente de acordo com o número de usuários ativos e pode ser estimado com base no número de licenças;
Um agente autônomo de IA. Uma pessoa define um objetivo e deixa o sistema trabalhar sozinho. O próprio sistema decide o que fazer e quantas etapas são necessárias. O custo continua aumentando até que a tarefa seja considerada concluída, sem um limite previsível.
Tokenomics em ataques: Denial of Wallet, o novo DDoS
Como as chamadas a LLMs são significativamente mais caras que as chamadas de software convencionais, automatizar tarefas corporativas rotineiras pode sair muito caro. Por exemplo, o Gartner estima que resolver uma única solicitação de suporte ao cliente usando um LLM custa aproximadamente US$ 3. É fácil imaginar como invasores poderiam bombardear uma empresa com milhares de solicitações longas e sofisticadas geradas por um LLM barato, causando um prejuízo financeiro significativo. Como o processo é automatizado, as anomalias podem não ser detectadas imediatamente.
Se um invasor souber qual sistema de agentes e qual LLM são usados em um processo de negócios, poderá realizar um ataque mais preciso e causar danos significativamente maiores. Os autores do estudo GitInject estimaram que um invasor capaz de criar incidentes no GitHub em uma organização que usa agentes de IA para análise de erros pode, com um único ataque (antes da ação dos mecanismos de defesa do GitHub), causar até US$ 111 em prejuízos e consumir 400 minutos do GitHub Actions da conta da vítima. Naturalmente, esse ataque pode ser repetido várias vezes, sem nenhum custo para o invasor.
O maior risco, embora seja difícil quantificá-lo em termos financeiros, vem de ataques que induzem os LLMs a um raciocínio excessivo. No artigo OverThink, os autores demonstraram como uma tarefa formulada de maneira inofensiva, quando enviada a um modelo de linguagem, produz um resultado correto, mas, nesse processo, consome 46 (!) vezes mais tokens do que deveria. Além disso, todas as tarefas testadas pelos pesquisadores passaram pelos filtros de segurança existentes.
Na nova versão do guia OWASP Top Risks for Language Models, esse problema alcançou a mais alta prioridade já registrada: o consumo ilimitado de tokens agora é classificado como LLM06:2026 e, entre suas variantes, o ataque de “denial of wallet” (negação de carteira), que esgota o orçamento da vítima para o uso de LLMs, é explicitamente destacado.
Como evitar ser vítima do “novo DDoS”
Antes de tudo, é preciso abandonar o princípio de “usar IA só por usar IA”. Não faz sentido delegar todas as tarefas a agentes autônomos. É recomendável analisar periodicamente o custo-benefício do uso de inteligência artificial.
Além disso, você deve limitar as permissões e o conjunto de ferramentas disponíveis para um agente autônomo de IA. Quanto menos ações o sistema puder executar, mais eficiente será em tarefas específicas, menos oportunidades terá de aumentar os custos e menor será a chance de alguém conseguir “manipulá-lo” para gastar tokens desnecessariamente.
Também recomendamos definir limites rígidos para o consumo de tokens e configurar um sistema de notificações para alertar as pessoas quando esses limites forem ultrapassados. Também é recomendável definir vários limites simultaneamente: por tarefa, por dia e assim por diante. Os alertas de limite excedido devem ser enviados imediatamente ao especialista responsável pelo sistema, para que ele decida se o processo deve continuar ou ser interrompido.
Verifique rigorosamente os dados externos não confiáveis. Qualquer informação processada pela IA que venha de fontes externas, como solicitações, consultas, mensagens, comentários ou campos técnicos que possam conter texto arbitrário (registros DNS, cabeçalhos HTTP, nomes de arquivos), pode não apenas levar à injeção de prompt, mas também aumentar deliberadamente a carga de trabalho. É recomendável limitar o tamanho desses dados e monitorar a carga que geram.
Calcule o custo unitário do trabalho e compare as faturas do fornecedor com seus próprios dados. O custo por análise, solicitação ou verificação é a única maneira de entender pelo que você está pagando e identificar erros nas faturas.
Há mais de duas décadas, configurar um roteador doméstico significa seguir praticamente a mesma rotina: escolher uma banda Wi-Fi, dar um nome à sua rede, escolher um tipo de segurança e definir uma senha. Depois de digitar o nome da rede, geralmente aparece ao lado uma opção para ocultar o nome da rede, às vezes identificada como ocultar SSID ou simplesmente como rede oculta ou rede fechada. Se você selecionar essa opção, a rede criada não aparecerá automaticamente na lista de redes Wi-Fi disponíveis em smartphones, computadores ou dispositivos de casa inteligente. Será necessário digitar manualmente o nome correto da rede. Somente então o dispositivo poderá localizar essa rede e se conectar a ela. À primeira vista, ocultar o nome da sua rede sem fio pode parecer uma precaução inteligente: impedir que vizinhos ou pessoas que passem pelo local invadam sua rede Wi-Fi, já que simplesmente não conseguem vê-la. Mas, na realidade, as coisas funcionam de maneira diferente: todos os seus dispositivos revelarão a existência da rede oculta, e isso não acontece apenas quando estão em casa.
Como os dispositivos se conectam ao Wi-Fi
Cada ponto de acesso Wi-Fi transmite um pequeno pacote de dados aproximadamente 10 vezes por segundo para que seu smartphone ou computador possa mostrar uma lista com os nomes das redes próximas, como JohnWiFi, TommyNet, CafeDeArts_Guest ou outras variações criativas. Esse pacote contém: (i) o nome da rede (Service Set Identifier, ou SSID), (ii) um identificador exclusivo do ponto de acesso (Basic Service Set Identifier, ou BSSID) e (iii) informações sobre o canal de rádio utilizado pela rede. Essas informações ajudam os dispositivos a (i) escolher a melhor rede para se conectar e (ii) ingressar automaticamente em redes que já conhecem. Por isso, nenhum dos dados desse pacote é criptografado. As redes ocultas também transmitem esses pacotes de anúncio; a única diferença é que deixam o campo SSID em branco. Esse método de localização de redes é chamado de descoberta passiva, pois um cliente Wi-Fi, como um smartphone, por exemplo, precisa apenas escutar as ondas de rádio para identificar os pontos de acesso próximos.
Além disso, o cliente pode procurar redes Wi-Fi por conta própria, em um processo conhecido como descoberta ativa. Seu smartphone ou computador transmite continuamente os nomes das redes Wi-Fi que conhece e às quais gostaria de se conectar. Se uma dessas redes estiver próxima, o ponto de acesso responde e a conexão é estabelecida.
A descoberta ativa pode, às vezes, ajudar a economizar a bateria do smartphone e é indispensável quando se trabalha com redes ocultas. Localizar uma rede oculta e conectar-se a ela torna-se um processo de duas etapas. Primeiro, o smartphone “detecta” que há um ponto de acesso Wi-Fi próximo com um nome de rede oculto. Em seguida, ele tenta acessar essa rede transmitindo os nomes (SSIDs) que já conhece, seja de redes ocultas às quais já se conectou anteriormente, seja do nome que o usuário digitou ao se conectar pela primeira vez a uma rede oculta. Se o nome corresponder, o roteador responde e a conexão é estabelecida.
Um nome de rede oculto (SSID) não oculta de fato sua rede Wi-Fi
A lista comum de redes Wi-Fi disponíveis no smartphone ou computador não exibirá as redes que não transmitem um SSID público. No entanto, qualquer software especializado de varredura de redes Wi-Fi pode identificá-las facilmente, ele apenas não exibirá seus nomes. Além disso, as redes ocultas continuam sendo fáceis de identificar e distinguir umas das outras graças ao BSSID exclusivo de cada roteador.
Portanto, ocultar o nome de uma rede Wi-Fi não a torna realmente invisível e não protege você contra cibercriminosos. Vale observar que qualquer análise em grande escala, como o mapeamento geográfico de redes Wi-Fi, utiliza BSSIDs, e não SSIDs. Além dos enormes bancos de dados mantidos pela Apple e pelo Google, também existem projetos públicos de mapeamento de pontos de acesso, como o WiGLE.
Se alguém quiser invadir uma rede em um local específico, um software especializado permite descobrir seu SSID simplesmente esperando que um dos clientes legítimos se conecte e monitorando a sessão de descoberta ativa. A partir daí, essa pessoa poderá se conectar à rede Wi-Fi, desde que ela utilize um protocolo de segurança suficientemente fraco.
Seus dispositivos expõem nomes de redes Wi-Fi ocultas e dados pessoais
A principal desvantagem de um SSID oculto é que smartphones e computadores precisam transmiti-lo antes de poderem se conectar à rede sem fio. E fazem isso em qualquer lugar, não apenas nas proximidades do ponto de acesso em questão. Assim que qualquer rede com um nome oculto aparece dentro do alcance do sinal, o cliente tenta se conectar e, durante essa tentativa, transmite os nomes de todas as redes ocultas que conhece. Essa transmissão não é criptografada, o que significa que qualquer pessoa nas proximidades pode capturar os dados transmitidos.
Em 2021, pesquisadores da Universidade de Hamburgo realizaram um experimento coletando dados de sinais de rádio em uma rua movimentada. Em apenas três sessões de uma hora de monitoramento, eles coletaram 252 mil solicitações de conexão Wi-Fi provenientes dos smartphones de pessoas que passavam pelo local. Dessas solicitações, 23% continham o SSID de uma rede à qual o smartphone teria preferido se conectar.
E é nesse ponto que entra em cena um fator em que poucas pessoas pensam: o próprio nome da rede. Doze por cento dos SSIDs identificados eram longas sequências numéricas que se pareciam muito com senhas. Assim, quando alguém conhece o SSID e o BSSID, pode consultar o BSSID em um serviço como o WiGLE e descobrir o endereço físico do ponto de acesso. Uma vez no local, um invasor pode tentar usar essa sequência tanto como SSID quanto como senha para se conectar à rede e com uma boa chance de sucesso. A amostra dos pesquisadores também incluiu 106 SSIDs que continham um nome ou sobrenome, 92 SSIDs que indicavam um endereço residencial e três que revelavam um endereço de e-mail.
Diante de tudo isso, não é de surpreender que Apple e Asus recomendem não usar o recurso de SSID oculto.
Outras desvantagens de ocultar sua rede Wi-Fi
Além dos problemas relacionados ao vazamento de dados, a tecnologia de SSID oculto (uma herança das primeiras versões do Wi-Fi) também prejudica o desempenho das versões modernas do protocolo de rádio. Na banda de 6 GHz, procurar uma rede Wi-Fi oculta entre 59 canais possíveis gera muito tráfego e consome muita energia: o cliente precisa percorrer todas as opções e enviar muitas solicitações. Como resultado, o desempenho de todas as redes Wi-Fi próximas na banda de 6 GHz diminui, e o próprio cliente consome mais bateria ao enviar todas essas solicitações.
A Asus também destaca que dispositivos Windows podem tender a se conectar primeiro a redes visíveis, mesmo quando uma rede com SSID oculto está disponível e marcada como preferencial.
Quando ocultar um SSID realmente faz sentido
Não há muitos cenários em que ocultar o nome da rede seja realmente útil. Por exemplo, se um roteador for destinado a um pequeno grupo de pessoas, mas estiver instalado em um local muito movimentado, um SSID oculto pode reduzir o número de tentativas de conexão e diminuir a carga sobre o roteador. Mas lembre-se de que isso melhora o desempenho, não a segurança, e apenas ligeiramente.
Outro caso semelhante é uma rede Wi-Fi técnica destinada a um número limitado de dispositivos fixos, como uma rede de câmeras de segurança ou dispositivos de casa inteligente. Esses dispositivos permanecem sempre no mesmo local, portanto, sempre que tentam se conectar à rede Wi-Fi designada, encontram-na imediatamente e nenhum dado é exposto; a menos que um invasor esteja efetivamente monitorando o sinal de rádio próximo ao roteador. Ao mesmo tempo, é menos provável que pessoas de fora tentem se conectar a uma rede desse tipo.
Como tornar seu Wi-Fi mais seguro
Para proteger sua rede Wi-Fi contra invasores que tentem acessá-la por meio da rede sem fio, não oculte o SSID. Em vez disso, use o moderno protocolo de segurança WPA3 junto com uma senha longa. Os invasores podem interceptar dados transmitidos pelo ar e, em seguida, tentar descobrir a senha por meio de ataques de força bruta. Por isso, uma senha Wi-Fi forte deve ter pelo menos 20 caracteres. A maneira mais fácil de gerar e armazenar senhas longas e difíceis de descobrir é usar um gerenciador de senhas que sincronize entre seus dispositivos. Dessa forma, elas estarão sempre à mão, independentemente do dispositivo que você estiver usando.
Se alguns de seus dispositivos mais antigos não forem compatíveis com WPA3, não há problema em usar WPA2 com Protected Management Frames (PMF) ativado, que protege contra vários tipos de ataques a redes Wi-Fi.
Você também deve se certificar de que o Wi-Fi Protected Setup (WPS) esteja desativado, pois ele basicamente substitui sua senha por um código PIN fácil de adivinhar.
Quanto ao nome da rede, em vez de ocultá-lo, escolha um que não revele seu nome, endereço ou qualquer outra informação pessoal. Também é recomendável evitar nomes de rede padrão, como ISPName-XXXX ou dlink, mas por outro motivo: nomes genéricos como esses podem confundir você e seus convidados. Se não quiser que seu ponto de acesso apareça nos mapas de geolocalização de redes Wi-Fi da Apple, do Google e de outros provedores, você pode adicionar o sufixo _nomap ao final do nome da rede, mas não há garantia de que isso realmente funcionará.
Além de proteger sua rede Wi-Fi, certifique-se de que seu roteador esteja configurado de forma segura de maneira geral. Antes de tudo, isso significa definir uma senha de administrador longa e exclusiva e manter o roteador atualizado com o firmware mais recente disponibilizado pelo fabricante. E, se tiver um pouco mais de tempo, você pode até melhorar o desempenho do seu Wi-Fi.
Como as redes Wi-Fi são invadidas e como protegê-las:
Imagine seu computador mantendo um diário, como os que crianças costumavam usar para registrar o dia a dia, ou viajantes, comerciantes e nobres mantinham séculos atrás. Imagine como ele poderia ser.
Segunda-feira, 7 de setembro.
O usuário leu as notícias em cnn.com e bbc.co.uk (Safari).
O usuário respondeu ao e-mail de John Kaufman sobre as datas de entrega e, em seguida, enviou a mesma pergunta à equipe de logística (Gmail).
O usuário conferiu a lista de tarefas, verificou as atualizações recentes e definiu as prioridades do dia (Lista de tarefas).
Não estamos exagerando. É exatamente assim que é o novo diário do seu Mac. São vários arquivos de texto que qualquer aplicativo no computador pode ler, assim como qualquer pessoa diante do teclado. O recurso é chamado de Histórico do computador e foi lançado pela OpenAI em meados de agosto. No momento, ele só funciona no ChatGPT para Mac, requer uma assinatura Pro ou superior e está desativado por padrão. Segundo os desenvolvedores, o Histórico permite que o assistente de IA entenda rapidamente o contexto do seu trabalho e responda até a solicitações vagas, como: “envie um lembrete para quem estava trocando e-mails comigo sobre as entregas da semana passada”. É claro que essa conveniência tem um preço: seus dados são processados nos servidores da OpenAI e podem vazar do Mac, seja para um familiar intrometido ou para criminosos cibernéticos.
Como o Histórico do computador do ChatGPT funciona
Se o recurso se parece muito com o Recall, da Microsoft, ou com o Chronicle, anunciado anteriormente pela própria OpenAI, não é por acaso. Ambos foram desenvolvidos com o mesmo objetivo, mas usam métodos diferentes. Depois de o Recall se transformar em um desastre de relações públicas, a equipe responsável pelo Histórico do computador decidiu não fazer capturas de tela nem analisá-las constantemente. Em vez disso, o ChatGPT usa os recursos de Acessibilidade do macOS para ler o texto na tela e acompanhar ações: cliques do mouse, texto digitado nos campos, alternância entre aplicativos e outras ações desse tipo. Tudo isso é armazenado como um fluxo de dados brutos de atividade dentro do contêiner do ChatGPT (grupo de aplicativos), acessível somente pelo próprio ChatGPT ou por outros aplicativos aos quais você tenha concedido permissão. Em testes executados por pesquisadores forenses digitais, apenas duas horas de uso normal do computador geraram cerca de 3.500 desses eventos registrados.
Esses dados brutos permanecem no computador por até 48 horas. Durante esse período, o aplicativo do ChatGPT executa periodicamente sessões de chat ocultas em segundo plano, nas quais pede à IA que reúna eventos relacionados em um único relato. Essencialmente entradas de diário, esses resumos são arquivos de texto simples em uma pasta que qualquer aplicativo do Mac pode abrir: ~/.codex/memories/extensions/skysight/.
Quando você conversa com o assistente ou ativa recursos automatizados, essas anotações podem ser incluídas na conversa para gerar respostas mais contextualizadas. A OpenAI faz questão de destacar que o assistente pode identificar padrões nos seus fluxos de trabalho e se oferecer para automatizá-los, criando o que chama de “skills”, que reproduzem suas ações automaticamente.
Depois que um resumo fica pronto, os dados brutos de atividade que deram origem a ele são excluídos. A OpenAI afirma que não manterá essas conversas ocultas em segundo plano nem as usará para treinar a IA, exceto quando isso for exigido por lei. Já os resumos em estilo de diário inseridos nas suas conversas ficam armazenados nos servidores da OpenAI sob as mesmas regras aplicadas às suas conversas regulares e à memória do assistente. Portanto, as configurações de privacidade que você já definiu também se aplicam a eles.
O que o Histórico do computador pode ver, e o que você pode desativar
Como o recurso funciona inteiramente com ferramentas de acessibilidade, o ChatGPT só acessa o que o sistema operacional já permite que essas ferramentas acessem. Isso inclui títulos de janelas, blocos de texto, legendas de imagens no navegador, o texto que você digita em um campo e os nomes dos elementos da interface em que você clica. Assistindo a um vídeo? A IA não consegue ver o vídeo em si, mas pode ler o título da janela, o nome do site e a descrição do vídeo. Navegando por fotos? Ela vê os nomes de arquivos e pastas, mas não as imagens propriamente ditas. O áudio nunca é gravado nem armazenado, em nenhuma situação. Em uma chamada de vídeo, tudo o que é registrado é o título da janela da reunião, a menos que as legendas ao vivo estejam ativadas na própria chamada. Os campos de senha mascarados (exibidos como pontos) não são lidos, e, segundo a OpenAI, as janelas de navegação privada nunca são analisadas.
Uma diferença em relação ao Microsoft Recall é que o procedimento para ativar o recurso é apresentado de forma clara e detalhada, passo a passo. O Histórico do computador nunca se ativa sozinho. Você deve navegar até o menu de configurações, depois Integrações → Histórico do computador e ativá-lo manualmente depois de ler os avisos e as explicações. Além disso, o acesso à memória do agente precisa estar ativado para que o recurso funcione. A partir daí, você escolhe quais aplicativos e sites deseja que sejam monitorados e confirma uma série de solicitações de permissão do macOS.
Para empresas que usam assinaturas comerciais, são necessárias duas aprovações: primeiro, o administrador deve ativar o Histórico do computador para toda a organização; depois, cada funcionário deve ativá-lo individualmente.
A qualquer momento, você pode acessar Histórico do computador → Permissões e listar aplicativos e sites específicos a serem excluídos do rastreamento ou, inversamente, definir o ChatGPT para monitorar apenas uma lista limitada de sua escolha (Incluir somente estes aplicativos, Incluir somente estes sites).
Para ver a aparência do diário do seu computador, verifique Histórico do computador → Histórico. A partir daí, você pode excluir entradas individuais ou desativar diretamente na lista o monitoramento de aplicativos específicos.
Os riscos de usar o Histórico do computador do ChatGPT
Já abordamos os riscos do armazenamento centralizado de toda a atividade de uma pessoa em nosso artigo anterior sobre o Microsoft Recall, e a maior parte do que dissemos também se aplica ao Histórico do computador do ChatGPT.
Você pode presumir que suas conversas e seus e-mails são privados, protegidos por senhas e criptografia. Mas uma cópia das partes mais importantes dessas conversas fica armazenada em arquivos de texto simples, acessíveis a qualquer pessoa com acesso ao seu computador e a muitos outros aplicativos.
As pessoas com quem você troca mensagens não fazem ideia de que essa cópia adicional existe. Por exemplo, se ativarem mensagens que se autodestroem, mas não marcarem a janela do aplicativo de mensagens como privada, essa precaução não as protegerá.
Mesmo que você confie plenamente na OpenAI e não questione as promessas de privacidade, seus dados ainda podem ser roubados diretamente do computador por um infostealer. Os infostealers direcionados a Macs aumentaram muito nos últimos dois anos, portanto, esse não é um risco meramente hipotético. Além disso, quem cria esse tipo de malware age rápido e o mantém sempre atualizado para capturar qualquer novo tipo de dado que pareça promissor. Os arquivos da OpenAI são uma verdadeira mina de ouro para eles: tudo o que você fez, já resumido pela IA em algo fácil de ler. Embora não contenham senhas nem números de cartão de crédito, os detalhes disponíveis provavelmente são suficientes para criar um golpe de e-mail com falso pedido do chefe, de forma convincente.
E, se um colega de trabalho intrometido ou alguém da sua família conseguir acessar seu computador, não levaria mais que cinco minutos para ler o diário da sua vida profissional e pessoal.
Histórico do computador: desativá-lo ou apenas configurá-lo?
Recomendamos limitar o Histórico do computador ou desativá-lo completamente se seu trabalho envolver informações confidenciais. Isso se aplica especialmente a médicos, advogados e qualquer outra pessoa sujeita ao sigilo profissional ou que lide com dados pessoais ou médicos. O mesmo vale para quem mora com um familiar controlador demais ou trabalha em um escritório com colegas intrometidos.
Se nada disso se aplicar a você e você quiser experimentar a utilidade real dos recursos de pesquisa e das skills geradas automaticamente pela IA, veja como configurar o recurso com segurança.
Bloqueie o login do seu Mac. Desative o login automático e configure o Mac para exigir uma senha imediatamente após o protetor de tela ser ativado ou o computador sair do modo de repouso. Use uma senha forte e o Touch ID, e certifique-se de que a criptografia de disco do FileVault esteja ativada.
Configure suas exclusões. Adicione manualmente à lista de exclusão do Histórico do computador todos os aplicativos de mensagens que você usa para conversas privadas, além de aplicativos ou sites financeiros e qualquer outro local onde você armazene informações confidenciais.
Verifique regularmente. Pelo menos algumas vezes por semana, acesse as configurações do Histórico do computador para verificar quais aplicativos e sites ele está monitorando. Isso ajuda a identificar e remover quaisquer fontes de informações privadas que você tenha esquecido de excluir antes.
Seja como você configure o Histórico do computador, as duas formas mais comuns de seus dados acabarem nas mãos erradas, em qualquer Mac, são um infostealer para macOS roubá-los diretamente do computador ou você inserir suas informações em um site falso. Para se proteger contra ambos, certifique-se de usar um software de segurança completo no Mac, como o Kaspersky para macOS.
A IA pode criar riscos à privacidade que você talvez nunca tenha imaginado. Você pode ler mais sobre outros riscos em nossas outras postagens:
Em 2026, o proprietário de um roteador doméstico comum, de uma smart TV ou de uma TV box é um alvo de grande interesse para os cibercriminosos. Esses dispositivos são facilmente recrutados para botnets e redes de proxy residencial, sobre as quais já falamos anteriormente.
Os criminosos “sublicenciam” o dispositivo infectado, permitindo que terceiros paguem para acessar qualquer site usando o endereço IP da vítima, fazendo parecer que é o proprietário do dispositivo quem está realizando os acessos. Esse serviço é procurado para todo tipo de esquema ilícito: desde fraude publicitária e campanhas de spam até tentativas de descoberta de senhas por força bruta e invasão de contas. Em nosso artigo anterior, explicamos como os roteadores domésticos são recrutados para essas redes de proxy; hoje, vamos analisar uma categoria de dispositivos ainda mais vulnerável e igualmente onipresente: smart TVs e TV boxes.
Esses dispositivos atraem os criminosos por dois motivos. Primeiro, ao contrário de computadores e smartphones, as TVs quase sempre ficam conectadas à tomada e têm uma conexão rápida com a Internet. Uma tela apagada não significa que o dispositivo esteja desligado. Além disso, a interface de usuário e as ferramentas de monitoramento limitadas fazem com que processos suspeitos executados em segundo plano possam passar facilmente despercebidos pelos usuários.
A ameaça está evoluindo e se tornando mais agressiva. Um estudo recente constatou que, quando um proxyware chega a um set-top box, os riscos para o proprietário vão muito além de ter o próprio tráfego desviado.
A estratégia de marketing da SuperBox se baseia fortemente na promessa de oferecer milhares de canais de TV sem assinatura nem mensalidades. No entanto, assim que sai da caixa, o dispositivo não é capaz de fazer nada disso. Para ter acesso a conteúdo pirata, é necessário instalar a loja de aplicativos proprietária da marca.
Quando você a abre e instala aplicativos adicionais, os milhares de canais de TV realmente aparecem. Enquanto isso, nos bastidores, sem nenhum aviso ou solicitação de permissão, o dispositivo inunda sites externos com solicitações não autorizadas, e o tráfego de rede aumenta drasticamente.
Os pesquisadores descobriram vários fatos alarmantes. Primeiro, a vítima pode ser incluída simultaneamente em até cinco botnets. A SuperBox executa clientes de várias redes de proxyware ao mesmo tempo, que chegam a competir entre si, bloqueando a instalação de softwares concorrentes.
Mas o verdadeiro choque foram os ataques à rede interna. O proxyware da TV box não impõe nenhuma limitação ao que seus “clientes” pagantes podem fazer na rede. Eles podem acessar não apenas sites externos, mas também dispositivos dentro da sua rede doméstica.
Normalmente, as configurações do seu roteador doméstico e do provedor de serviços de Internet (ISP) protegem você contra ataques externos. Mas o proxyware contorna essas barreiras porque opera de dentro da rede. Durante um experimento, os pesquisadores confirmaram que um invasor na Internet pode facilmente usar o set-top box infectado para abrir o painel de administração de um roteador doméstico, como um Linksys, que deveria estar acessível apenas ao proprietário quando conectado à rede Wi-Fi doméstica. Isso significa que os hackers podem tentar roubar dados de outros dispositivos da mesma residência ou até mesmo criptografar o armazenamento de rede doméstico (NAS).
Ao mesmo tempo, falhas no firmware de fábrica da SuperBox permitem que hackers instalem e executem remotamente qualquer aplicativo com privilégios de superusuário, e essa ameaça está longe de ser apenas hipotética. Durante três semanas de monitoramento, o set-top box usado no teste sofreu mais de 1.300 ataques por meio da rede de proxy doméstica. Os invasores instalaram três tipos diferentes de malware, incluindo um módulo para realizar ataques DDoS.
O malware usa vários métodos para obter acesso ao sistema e permanece ativo mesmo após reinicializações e quedas de energia.
Como saber se seu set-top box está trabalhando para os hackers
Se você tem um set-top box barato ou uma Android TV de uma marca pouco conhecida, vale a pena verificar se há alguma anomalia.
O método mais confiável é analisar o tráfego de rede. Use as estatísticas disponíveis no painel de controle do seu roteador, mas observe que alguns modelos de baixo custo podem não oferecer esse recurso. Nos roteadores Asus, esse recurso é chamado de Traffic Analyzer; nos TP-Link, de Traffic Usage; e nos Keenetic, de Traffic Monitor. Encontre sua TV ou set-top box na lista de dispositivos e verifique a proporção entre os dados baixados e enviados. Esses dispositivos devem consumir muito tráfego para baixar vídeos, mas enviar pouquíssimos dados. Se seu set-top box estiver silenciosamente enviando gigabytes de dados ou permanecer ativo na rede mesmo quando estiver ocioso, esse é um sinal claro de que ele pode estar infectado.
Se as estatísticas de tráfego não estiverem disponíveis, procure sinais indiretos:
Os LEDs de atividade da rede e da memória não param de piscar, mesmo quando ninguém está usando o dispositivo.
O gabinete do set-top box fica constantemente morno ou quente.
A interface apresenta atraso em relação ao controle remoto, e o set-top box trava aleatoriamente, sem relação com a reprodução de vídeos pesados.
A velocidade da Internet nos outros dispositivos (computadores ou celulares) sofre uma queda significativa.
Ao tentar acessar sites conhecidos pela rede Wi-Fi doméstica, você se depara constantemente com um CAPTCHA, um sinal de que sua rede pode estar comprometida e ter sido identificada como fonte de spam.
O suporte técnico do seu provedor de serviços de Internet entra em contato para perguntar sobre um volume de tráfego de rede suspeito.
O que fazer com um dispositivo infectado
A melhor solução é desconectar o dispositivo da Internet e descartá-lo. Se precisar continuar usando-o, siga estas etapas para minimizar os riscos:
Realize uma redefinição de fábrica (hard reset). Restaure o set-top box ao estado original.
Deixe-o desconectado da Internet antes de configurá-lo novamente. Na primeira vez que ligá-lo após a redefinição, ignore a etapa de configuração do Wi-Fi e não conecte o cabo Ethernet.
Bloqueie a instalação de aplicativos. Acesse as configurações do Android e desative a instalação de aplicativos de fontes desconhecidas. Não se esqueça de desativar todos os recursos de depuração que estiverem ativados: depuração USB, depuração sem fio e ADB. Os nomes dos itens de menu podem variar de acordo com a versão do Android e o fabricante do dispositivo.
Isole-o na rede. Configure uma rede Wi-Fi para convidados no roteador e conecte a TV box a ela. Ative o isolamento de clientes (Client Isolation) nas configurações do roteador, se esse recurso estiver disponível. Isso impedirá que a TV box detecte outros dispositivos da sua rede doméstica, protegendo seus computadores e o armazenamento de rede.
Verifique se há atualizações. Depois que a TV box estiver conectada à rede para convidados, verifique se há atualizações oficiais de firmware. Às vezes, os fabricantes corrigem vulnerabilidades conhecidas, embora não seja recomendável contar com isso no caso de marcas pouco conhecidas.
Suas medidas de proteção mais confiáveis
Comprar dispositivos baratos com recursos de streaming de conteúdo pirata e instalar softwares de fontes duvidosas é uma maneira praticamente certa de comprometer sua rede doméstica. Seu endereço IP se tornará uma fonte de atividade maliciosa, o que, na melhor das hipóteses, fará com que seu provedor de serviços de Internet bloqueie seu acesso e, na pior das hipóteses, fará com que você entre no radar das autoridades policiais. Além disso, os hackers podem usar a TV box como ponto de partida para atacar seus computadores e NAS domésticos, o que pode levar ao roubo de dados pessoais ou a um ataque de ransomware.
A melhor proteção é comprar dispositivos de marcas confiáveis e pagar por conteúdo legal. Além disso, para evitar que alguém assuma o controle da sua rede, certifique-se de que o painel de administração do roteador e os outros dispositivos domésticos estejam protegidos por senhas fortes e exclusivas. Para não precisar memorizar todas elas, use um gerenciador de senhas confiável, como o Kaspersky Password Manager. Além disso, o recurso Smart Home Monitor incluído no Kaspersky Premium permite manter todos os seus dispositivos sob controle.
Talvez haja outras coisas que você não saiba sobre seus dispositivos de casa inteligente:
Os threat actors desenvolvem constantemente novos esquemas de ataque, desde roubo de token OAuth até ataques a agentes de IA, mas os métodos clássicos nunca saem completamente de seu repertório. Em qualquer dia, um funcionário pode receber malware anexado diretamente a um e-mail ou à espreita atrás de um link incorporado em um e-mail. Tornar esses ataques bem-sucedidos ainda requer um grau de criatividade e, nos últimos anos, os invasores adotaram cada vez mais formatos de arquivo exóticos. Os usuários não consideram esses formatos perigosos; mais importante ainda, muitas soluções de EDR e de segurança de e-mail ignoram totalmente esses formatos. No entanto, eles provaram ser altamente eficazes na implementação de malware ou na coleta de credenciais.
A seguir estão os tipos de arquivo que podem representar pontos cegos na estratégia de detecção da sua organização, apesar de já terem sido observados em ataques cibernéticos reais.
Imagens de disco
Essa é a categoria de anexos mais ampla e perigosa. Uma imagem de disco pode conter um conjunto de arquivos totalmente preparado e corretamente estruturado, adaptado a uma ampla variedade de cenários de ataque. Ela é montada como um volume separado (disco virtual independente) e, nesse processo, geralmente usa ferramentas integradas ao sistema operacional. A vítima não precisa descompactar nada nem criar diretórios suspeitos no disco.
O formato mais versátil é o ISO, herdado da era dos CDs multimídia. As imagens ISO são montadas nativamente em todos os principais sistemas operacionais, sem a necessidade de utilitários adicionais, seja por meio de ferramentas simples, como o Explorador de Arquivos, ou pela interface de linha de comando. É exatamente por isso que os threat actors enviam arquivos ISO como anexos de e-mail sem hesitar.
Os contêineres IMG são um pouco menos comuns; eles também podem ser montados sem ferramentas adicionais no macOS ou Linux, mas exigem a instalação de um pequeno utilitário gratuito, como o OSFMount, no Windows, ou o uso do WSL2 (Windows Subsystem for Linux), que vem integrado às versões recentes do Windows. Um arquivo com conteúdo idêntico pode ter a extensão DD.
Os threat actors também usam VHD, um formato de disco virtual nativo do Windows que também funciona em máquinas Linux (via qemu-nbd ou guestmount). No macOS, porém, um utilitário adicional como o qemu-nbd é necessário para a montagem. Observe que em sistemas Windows sem patches, a vítima não precisa fazer nada após montar o disco: o CVE-2025-24993, uma vulnerabilidade ativamente explorada em ataques reais, dispara a execução automática logo após montar a imagem.
Para completar: também vale a pena detectar o VMDK, formato de imagem de disco usado pelo VMware, embora ele seja, em grande parte, ineficaz em ataques contra usuários comuns, pois todos os sistemas operacionais populares exigem software adicional para montá-lo.
Todos esses formatos de imagem podem ser visualizados e descompactados tanto com ferramentas especiais para arquivos comprimidos, quanto com utilitários padrão como 7-Zip ou RAR. Como resultado, as chances de o usuário cair nessa armadilha são surpreendentemente altas.
Além disso, como não são reconhecidos como formatos perigosos, imagens de disco oferecem aos invasores outra vantagem: arquivos extraídos delas no Windows geralmente carecem do sinalizador Mark of the Web, e podem ser iniciados sem nenhum alerta adicional do sistema.
Há mais uma razão para o EPP/EDR verificar máquinas virtuais e imagens de disco: esses formatos também são usados nos estágios posteriores de um ataque. Para ocultar a atividade do sistema de arquivos das ferramentas de monitoramento, gangues de ransomware às vezes executam todo o processo de criptografia em uma máquina virtual no computador da vítima. A cepa de ransomware RagnarLocker usou o VirtualBox para essa finalidade, enquanto a campanha CRON#TRAP contou com um ambiente QEMU.
Arquivos do MS Office
Não, não se trata de arquivos DOC com macros. A Microsoft bloqueou completamente as macros em documentos baixados, exigindo um esforço considerável do usuário para ativá-las, e ativá-las requer um esforço considerável do usuário. Mas, o Office conta com dezenas de formatos de arquivo, e alguns dos menos comuns ainda oferecem brechas aos invasores.
Os arquivos OneNote (.one) são menos familiares aos usuários e às soluções de segurança. Embora sejam simples notas, podem conter anexos incorporados, incluindo não apenas imagens, links e scripts, mas também scripts VBS/WSF/BAT. Normalmente, um anexo aparece como um ícone dentro da nota, mas os invasores o cobrem com uma imagem que simula uma mensagem com o botão “Visualizar”.
Outro formato do Office popular entre invasores é o complemento do Excel. Embora usem a extensão .xll, esses arquivos são, na verdade, DLLs (bibliotecas de vínculo dinâmico) completas do Windows com funcionalidade irrestrita. As vítimas recebem um e-mail com um documento que parece uma fatura; o ícone sugere que abrirá no Excel. Ignorar o aviso de segurança resulta em infecção por infostealer.
SVG “gráficos”
A descrição do formato SVG (Scalable Vector Graphics) soa totalmente inofensiva. De fato, 99% dos arquivos SVG são logotipos e ícones de interface. Diferentemente de PNG ou JPG, porém, arquivos SVG são documentos XML que podem conter não apenas formas geométricas, mas também JavaScript. Em termos de potencial malicioso, o SVG não fica muito atrás de uma página da Web completa. Em ataques reais, os arquivos SVG podem redirecionar usuários para páginas de phishing ao abrir, ou renderizar a página decodificando um bloco codificado em Base64 em HTML.
Arquivos SVG representam um risco significativo para portais corporativos que aceitam uploads de usuários. Se a Política de Segurança de Conteúdo (CSP) não for suficientemente restritiva, um SVG malicioso carregado pode ter seu JavaScript roubar cookies, injetar conteúdo ou sequestrar credenciais.
Arquivos poliglotas
Os formatos de arquivos poliglotas são menos exóticos por si mesmos, mas contêm mais do que o esperado. Eles são chamados de arquivos poliglotas porque os invasores criam um arquivo que pode ser interpretado corretamente de várias maneiras. Por exemplo, ele pode ser, ao mesmo tempo, um arquivo ZIP válido e um executável válido. O objetivo é evitar detecção por soluções de segurança e enganar o usuário. Abordamos os arquivos poliglotas detalhadamente em uma postagem separada.
O destaque em nosso resumo é uma campanha maliciosa que distribui o infostealer IcedID. As vítimas recebem e-mails com um anexo ZIP contendo uma imagem ISO. Isso ainda é descompactado em um arquivo CHM (formato de Ajuda do Windows) que funciona como aplicativo mshta (host de aplicativos HTML da Microsoft), baixando o malware principal.
Proteção contra arquivos exóticos
Esses ataques exploram a falha de muitas soluções de segurança em verificar formatos incomuns ou inspecioná-los adequadamente. Para se defender da ameaça, comece por presumir que a sua infraestrutura não tem essa limitação:
Configure seu EDR, filtros da Web e de e-mail para verificar todos os formatos descritos acima.
Trate arquivos comprimidos e imagens de disco com o mesmo rigor dos executáveis.
Teste tipos de arquivo potencialmente perigosos em um sandbox e configure descompactação recursiva de formatos aninhados até o fim da cadeia: ZIP → ISO → CHM.
Quando possível, coloque em quarentena formatos anômalos para e-mail, especialmente imagens de disco.
Crie regras para detectar padrões anômalos envolvendo arquivos exóticos. Por exemplo, imagens de disco muito pequenas são raras e merecem investigação.
Verifique se suas soluções usam análise estrutural profunda para detectar formatos complexos, não apenas verificações de bytes mágicos.
Implemente detecção comportamental para identificar padrões anômalos e utilitários legítimos em contextos suspeitos. Os principais suspeitos são: mshta, git, wscript, hh e rundll32.
Os arquivos SVG exigem uma política de segurança específica. Trate SVGs como conteúdo executável no e-mail e no perímetro da rede. Em portais corporativos, implemente um CSP rigoroso e sirva arquivos enviados por usuários de um subdomínio separado, impedindo que scripts maliciosos em SVGs acessem a sessão da página principal.
Arquivos criados com a técnica poliglota têm aparecido cada vez mais em ciberataques nos últimos anos. Eles permitem que os invasores façam o malware passar pelos filtros de e-mail e pelos verificadores de arquivos, enganem as vítimas em ataques de phishing e dificultem as investigações de incidentes. Para conseguir isso, os invasores constroem deliberadamente um arquivo que o sistema pode interpretar como formatos diferentes, dependendo do aplicativo em que ele é aberto. Um exemplo clássico é um arquivo que pode ser tratado como uma imagem PNG ou um arquivo ZIP. Basta alterar a extensão do arquivo ou simplesmente usar um ou outro aplicativo para abri-lo.
Vamos entender por que é possível criar arquivos desse tipo, quais combinações de formatos já foram usadas em ataques reais e como as organizações podem se proteger contra essa ameaça.
Por que é possível criar arquivos poliglotas
Os formatos de dados por trás dos arquivos poliglotas raramente são exóticos. Tudo se resume a uma combinação inteligente de formatos comuns que são estruturalmente compatíveis. Os poliglotas exploram pelo menos uma das seguintes peculiaridades em determinados formatos de arquivo:
A maioria dos formatos de arquivo precisa ser decodificada a partir do primeiro byte, mas alguns precisam ser lidos a partir do final. O exemplo mais claro é um arquivo ZIP: um início corrompido ou ausente não impede que os aplicativos leiam o arquivo, porque todos os cabeçalhos necessários ficam no final. Isso permite que os invasores simplesmente concatenem dois arquivos (no exemplo acima, um PNG e um ZIP). A parte inicial é lida como uma imagem PNG válida, enquanto a parte final é lida como um arquivo ZIP válido.
Muitos formatos funcionam como bonecas russas matrioscas: embora externamente tenham uma extensão específica correspondente ao uso pretendido, internamente o arquivo é, essencialmente, um arquivo ZIP que contém os dados necessários. Esse grupo inclui documentos modernos do Office (DOCX/XLSX/PPTX), pacotes de instalação do Android (APK), arquivos de biblioteca Java (JAR) e muitos outros.
Alguns formatos não têm requisitos estruturais rígidos ou têm requisitos suficientemente flexíveis para que o aplicativo que processa o arquivo consiga localizar o trecho de que precisa, mesmo quando esse trecho não está no início.
O repositório Polydet no GitHub apresenta vários exemplos de combinações possíveis de arquivos para criar um arquivo poliglota. De acordo com a classificação da MITRE, essa técnica se enquadra na categoria Masquerading (T1036.008, Masquerade File Type).
Exemplos de arquivos poliglotas em ciberataques conhecidos
Análises de campanhas de malware disponíveis publicamente revelam diversos tipos de arquivos poliglotas. Os invasores adaptam todo o cenário do ataque a uma combinação específica de tipos de arquivo.
O grupo Head Mare entregou o malware PhantomPyramid como um anexo ZIP. O arquivo consistia em código executável do Windows (EXE), com um pequeno arquivo ZIP concatenado ao final. Quando a vítima abriu o arquivo compactado, ele continha um arquivo com a extensão PDF.LNK que, então, iniciava esse mesmo anexo poliglota, desta vez como um arquivo executável.
No ataque documentado pela JPCERT, os invasores criaram um arquivo que começava como PDF e era detectado como PDF pela maioria dos verificadores, mas tinha uma extensão DOC e era aberto nos aplicativos do Office como um arquivo DOC válido contendo macros maliciosas.
Os ataques que disseminaram os cavalos de Tróia StrRAT e Ratty usaram um arquivo poliglota criado a partir de um pacote de instalação assinado do Windows (MSI), com código Java malicioso (JAR) anexado ao final.
Os ataques do StrelaStealer usaram um arquivo poliglota com extensão HTML: uma biblioteca do Windows (DLL) com um documento HTML de chamariz concatenado ao final. Um atalho no arquivo compactado iniciou o arquivo duas vezes: uma vez por meio do comando start (o equivalente a um clique duplo, que abriu um navegador exibindo o documento HTML) e outra por meio do rundll32 (que iniciou a DLL maliciosa).
Em um ataque simulado, mas engenhoso, os pesquisadores concatenaram dois arquivos ZIP comuns e descobriram que diferentes ferramentas populares de compactação exibiam o arquivo combinado de maneiras diferentes: algumas mostravam apenas o primeiro arquivo compactado, outras apenas o segundo, e outras mostravam ambos ao mesmo tempo, como se fossem um único arquivo compactado com conteúdo compartilhado. Se o invasor estiver familiarizado com a infraestrutura da vítima e souber quais softwares estão instalados, poderá usar essa combinação para mostrar um arquivo às ferramentas de segurança e outro à vítima.
Os invasores empregaram uma complexa matriosca de malware em uma campanha que distribuiu o infostealer IcedID. Eles anexaram um arquivo ZIP aos e-mails de phishing; descompactá-lo produziu um arquivo ISO. Esse ISO, por sua vez, era descompactado em um arquivo CHM (Ajuda do Windows) criado com a técnica poliglota. Quando a vítima o abriu com a ferramenta padrão de Ajuda do Windows, o arquivo executou um script JavaScript incorporado ao conteúdo da ajuda, que iniciou o aplicativo padrão mshta (host de aplicativos HTML da Microsoft) e o direcionou para esse mesmo arquivo CHM. Os autores da campanha empacotaram um aplicativo HTA dentro do arquivo CHM de forma que sua presença não interferisse na leitura do arquivo como um documento de ajuda inócuo. O manipulador de HTA, por sua vez, simplesmente ignora todos os dados irrelevantes no início do arquivo até encontrar o script HTA.
Como as ferramentas de segurança lidam com arquivos poliglotas
Os exemplos acima deixam claro como esse truque de leitura dupla permite que os invasores implantem malware no computador da vítima. Mas como os filtros de e-mail e os sistemas EDR realmente lidam com arquivos desse tipo? A resposta depende inteiramente da solução específica, portanto, isso precisa ser verificado, seja por meio da análise da documentação técnica do fornecedor, seja pela execução de um teste controlado na infraestrutura corporativa, com todas as devidas precauções. De modo geral, apenas dois pontos são válidos em todos os casos:
A maioria das soluções de segurança não confia na extensão informada de um arquivo; em vez disso, verifica seu início para determinar sua estrutura real. É por isso que, no ataque descrito acima, o arquivo PDF com extensão DOC foi analisado como um PDF inofensivo, enquanto a macro maliciosa estava na parte DOC concatenada.
Se um arquivo começar como algo inofensivo (por exemplo, uma imagem) e sua extensão corresponder, uma análise mais sofisticada provavelmente não será aplicada a ele. Os invasores podem explorar isso: as instruções que acompanham o arquivo podem orientar a vítima a renomeá-lo para que o comportamento do sistema acabe associado à segunda carga útil, e não à imagem.
Como proteger uma organização contra ataques de arquivos poliglotas
A defesa contra arquivos poliglotas não requer soluções técnicas ou organizacionais complexas. O que exige são boas práticas de segurança sólidas e consistentes em toda a organização:
use listas fechadas de aplicativos autorizados a serem executados nas estações de trabalho dos funcionários. exclua aplicativos do Windows desatualizados, ferramentas administrativas da Microsoft não utilizadas, softwares de acesso remoto e de transferência de arquivos e qualquer outro software considerado potencialmente perigoso ou obsoleto.
use soluções de segurança de e-mail avançadas e equipadas com CDR (tecnologia de Desarme e Reconstrução de Conteúdo, que desarma anexos suspeitos e os reconstrói em versões mais seguras) e tecnologia de detonação (que executa anexos suspeitos em um ambiente isolado para análise). configure a análise aprofundada para anexos que apresentem sinais externos de serem arquivos poliglotas: todos os arquivos compactados e do Office, arquivos com extensões não padrão e assim por diante.
da mesma forma, configure a solução EDR para realizar uma análise aprofundada de possíveis arquivos poliglotas.
crie regras de monitoramento que gerem alertas para combinações incomuns entre um processo e os arquivos que ele recebe para processamento, como um arquivo CHM iniciado por meio do mshta ou um arquivo HTML iniciado por meio do rundll32, como nos exemplos acima.
adicione informações básicas sobre arquivos poliglotas ao programa de conscientização em segurança utilizado pela organização, para que os usuários fiquem atentos quando forem orientados a alterar a extensão de um arquivo ou a manipulá-lo de alguma forma incomum, por exemplo, abrindo-o em um aplicativo específico.
Um artigo recente publicado na The Atlantic trazia o título contundente The End of Reading Is Here (O fim da leitura chegou). Segundo a matéria, uma pesquisa do National Endowment for the Arts (NEA) constatou que menos de 50% dos adultos americanos leram sequer um livro em 2022, e apenas 38% leram um romance ou conto.
Ao mesmo tempo, o mercado editorial nos Estados Unidos continua quebrando recordes de publicação ano após ano. Em 2025, por exemplo, o número de novos títulos ultrapassou quatro milhões, um aumento de um terço em relação a 2024. Uma enorme parcela desse total, 3,5 milhões de títulos, veio da autopublicação, e um dos principais motores desse mercado é o Kindle Direct Publishing (KDP), da Amazon.
Minha teoria para essa discrepância é a seguinte: ninguém mais lê livros, porque todo mundo está ocupado demais escrevendo-os. Brincadeiras à parte, se ainda houver algum leitor por aí, provavelmente já terá adivinhado aonde quero chegar: à toda-poderosa IA. Um tempo atrás, uma jornalista de tecnologia do New York Times se surpreendeu ao encontrar sua própria biografia na Amazon. Uma rápida olhada confirmou que ela havia sido escrita por IA. Ao investigar mais a fundo o universo da publicação de livros por IA, ela se deparou com o trabalho de um consultor de cibersegurança aposentado e extraordinariamente prolífico. O que aconteceu depois, e onde encontrar informações confiáveis na era da IA, é o tema deste post.
O começo da história: como uma jornalista seguiu o Coelho Branco e caiu na toca
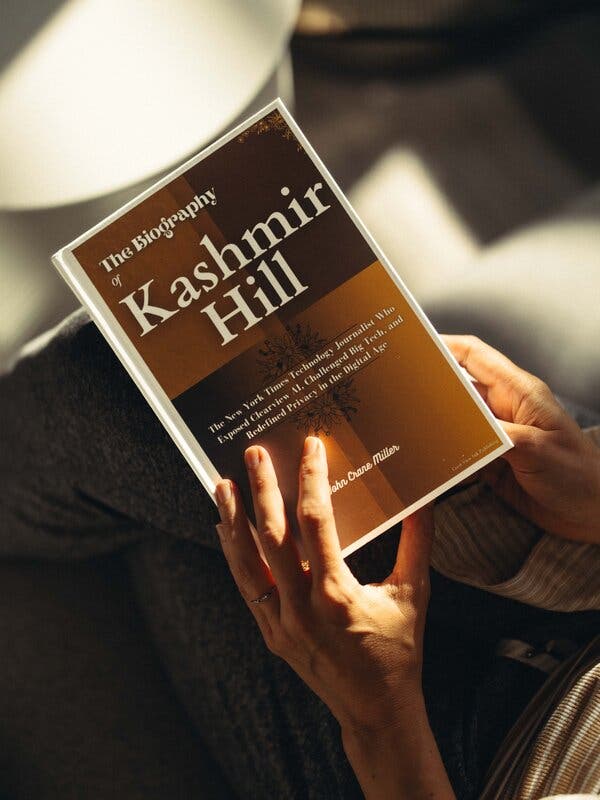
Vamos começar do início. No verão de 2026, a jornalista de tecnologia do New York Times Kashmir Hill descobriu por meio de um conhecido que uma biografia sua havia sido publicada na Amazon um ano antes. O título era The Biography of Kashmir Hill: The New York Times Technology Journalist Who Exposed Clearview AI, Challenged Big Tech and Redefined Privacy in the Digital Age. E ela ficou mais do que surpresa, pois ninguém havia entrado em contato com ela ou com qualquer pessoa que conhecesse para fazer uma pesquisa sobre o livro.
“Alice pôs-se de pé num salto, pois lampejou-lhe na mente que nunca antes vira um coelho com um bolso de colete, nem com um relógio para tirar dele… “
O autor era um certo John Crane Miller, e a foto em sua página na Amazon era uma imagem genérica de banco de imagens de um homem branco do tipo que aparece por toda a Internet. Hill não conseguiu encontrar nenhum detalhe pessoal nem informação de contato sobre ele. Ao investigar mais a fundo o perfil dele na Amazon, porém, descobriu outra coisa: em uma única semana no verão de 2025, ele publicou biografias de Hill e de mais nove jornalistas americanos. Até o leitor mais crédulo teria dificuldade para acreditar que um gênio literário conseguiria produzir tamanho volume sem uma ajudinha robótica.
A biografia da jornalista Kashmir Hill gerada por IA, que ela encontrou por acaso na Amazon. Fonte
Ainda assim, a edição de capa dura da biografia de Kashmir Hill custava US$ 26,99, embora tivesse apenas 90 páginas. Depois de lê-la, Hill descobriu toda uma série de “fatos” sobre si mesma que jamais conhecera, incluindo uma descrição detalhada de seu ritual de preparo do café que, como observa a jornalista, na verdade é tarefa do marido. Miller chegou a afirmar no texto que havia lido o diário de infância de Kashmir Hill.
“…e, ardendo de curiosidade, correu pelo campo atrás dele, e felizmente chegou a tempo de vê-lo entrar de chofre numa toca de coelho grande sob a sebe. “
Hill não conseguiu localizar o autor de sua biografia. Deixou um comentário na página do livro na Amazon pedindo que ele entrasse em contato. Ninguém respondeu e, pouco depois, todos os livros do perfil de John Crane Miller desapareceram.
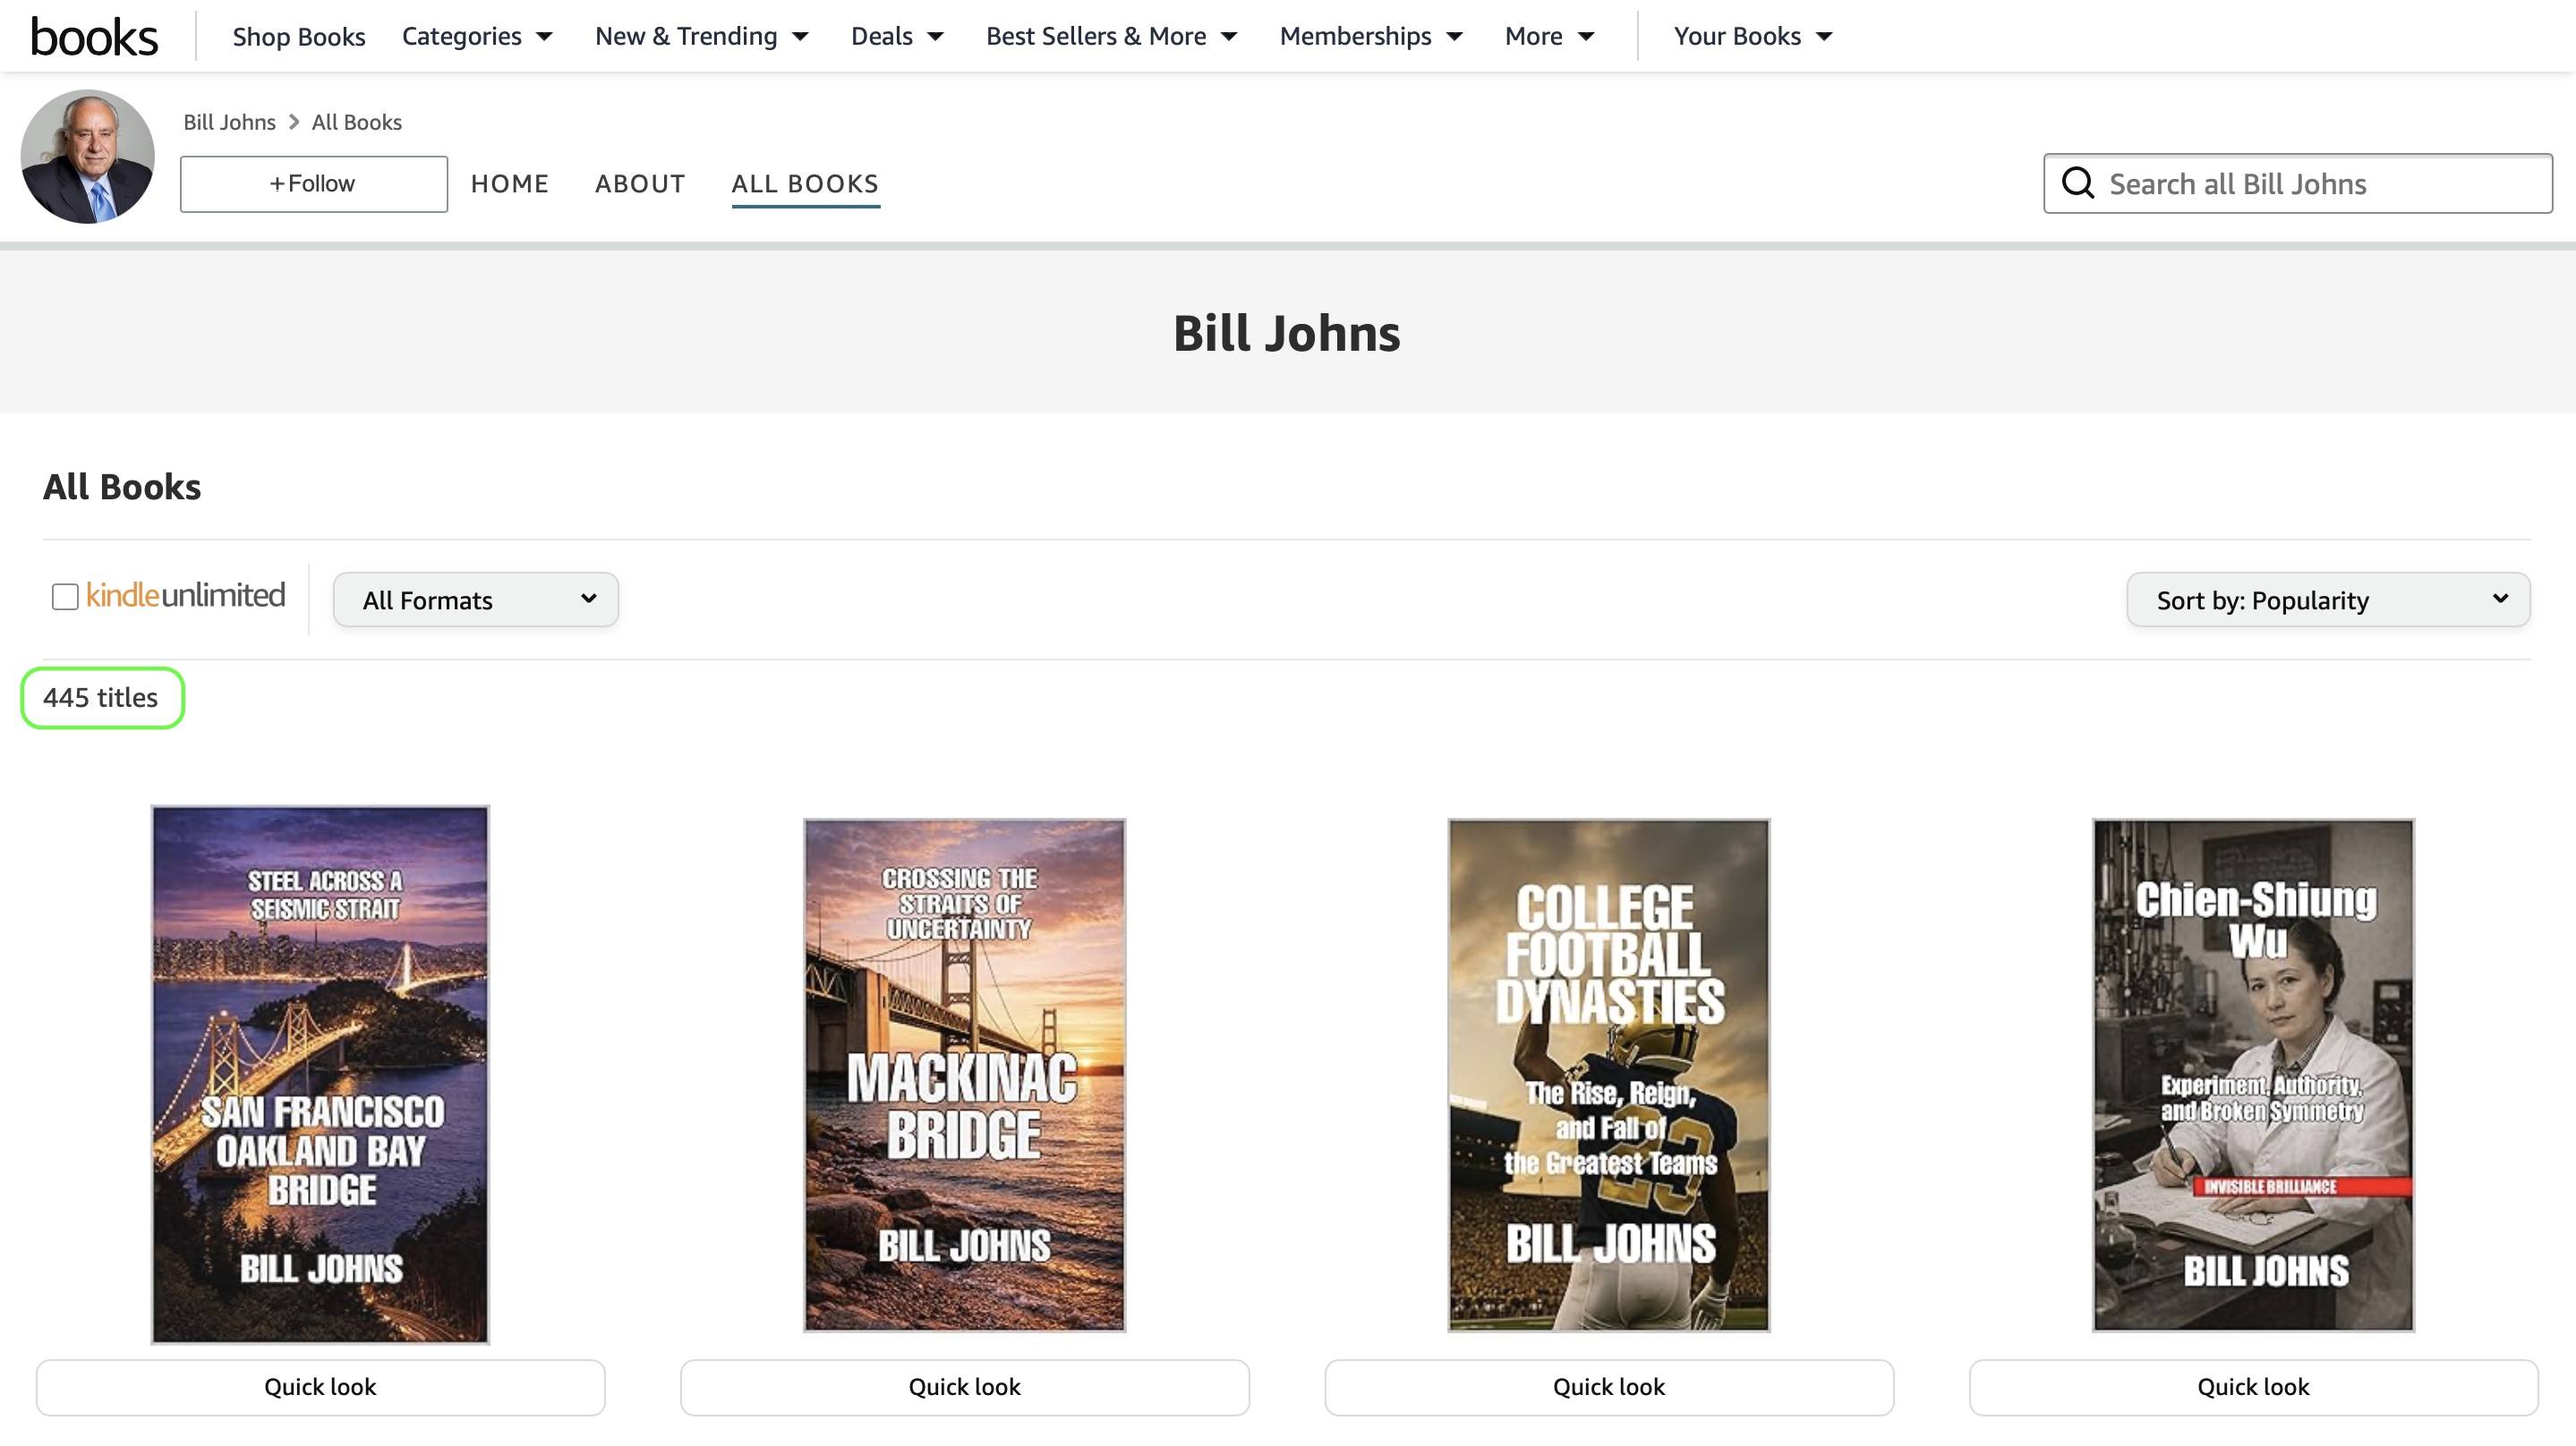
Mas isso lhe deu uma pista sobre vários outros autores de IA na Amazon. Em particular, ela encontrou um certo Bill Johns, cuja página de autor exibia impressionantes 445 livros. Sem esperar que desse em muita coisa, perguntou a Johns se ele aceitaria conceder uma entrevista e ficou bastante surpresa quando ele concordou. Foi provavelmente nesse momento que a investigação de Kashmir Hill se transformou em uma verdadeira viagem pela toca do coelho da IA…
“No momento seguinte, lá se foi Alice atrás dele, sem considerar, nem por um momento, como no mundo sairia de lá novamente. “
As IAventuras de Bill no País das Maravilhas
Bill Johns se aposentou em 2024, depois de construir carreira como consultor de cibersegurança. Em 2025, decidiu experimentar o ChatGPT e, em algumas semanas, usou a ferramenta para gerar seu primeiro livro. O tema era cibersegurança, mais especificamente a história do hacking, e a obra foi publicada com o nada original título Ghosts in the Machine. Johns vendeu apenas alguns exemplares, mas isso não o impediu de gerar outros 444 livros no ano seguinte.
Página de autor de Bill Johns na Amazon. Em um único ano, ele publicou 445 livros, sobre temas que vão de cibersegurança e… Pontes a esportes, biografias e filosofia. Fonte
Esse número impressionante inclui, por exemplo, uma série de 13 livros sobre cibersegurança que, além da já mencionada história do hacking, contém os seguintes títulos (em tradução livre):
The Cybersecurity Blueprint: Building and Operationalizing a Complete Defensive Strategy (O Plano diretor de cibersegurança: Construindo e operacionalizando uma estratégia defensiva completa)
Hardware Fortress: The Role of Data Diodes in Protecting Critical Infrastructure (Fortaleza do hardware: O papel dos diodos de dados na proteção de infraestruturas críticas)
Zero Trust: Redefining Security in a Perimeterless World (Zero confiança: Redefinindo a segurança em um mundo sem perímetros)
Evolving Threats, Evolving Chains: Cybersecurity for the Modern Supply Chain (Ameaças em evolução, cadeias em evolução: cibersegurança para a cadeia de suprimentos moderna)
The Integration Imperative: Cybersecurity for Legacy OT/ICS: Overcoming the Challenges of Digital Transformation in Critical Infrastructure (O imperativo da integração: Cibersegurança para OT/ICS legados — superando os desafios da transformação digital em infraestruturas críticas
A cibersegurança está longe de ser o único tema, ou sequer o principal, na mente desse prolífico autor. Além dela, a obra de Bill Johns abrange esportes, pontes, bebidas alcoólicas de todos os tipos, como saquê e uísque, biografias de personalidades, aviação militar e filosofia. Em resumo, é difícil pensar em um assunto sobre o qual Johns ainda não tenha escrito um livro.
O “processo criativo” de Johns consiste em planejar os capítulos de um livro com o ChatGPT e depois escrever cada um gradualmente. Segundo o próprio Johns, pedir à IA que gere um capítulo inteiro de uma só vez não funciona muito bem (para surpresa de ninguém…). Então, é melhor produzir o texto aos poucos. Quando necessário, ele pede ao ChatGPT que faça revisões. Depois da publicação, compra na Amazon um exemplar de cada um de seus 445 livros, mas apenas para colocá-lo na estante, já que lê-los provavelmente não faz parte do plano. Na visão de Johns, ele leu os livros enquanto estavam sendo gerados. E isso basta.
A meta desse titã literário é gerar 10 livros por semana, exatamente o máximo que a Amazon permite nesse período. Há apenas três anos, esse limite era duas vezes maior. Dito isso, ao contrário do autor da biografia de Kashmir Hill, os livros de Johns costumam ser consideravelmente mais longos.
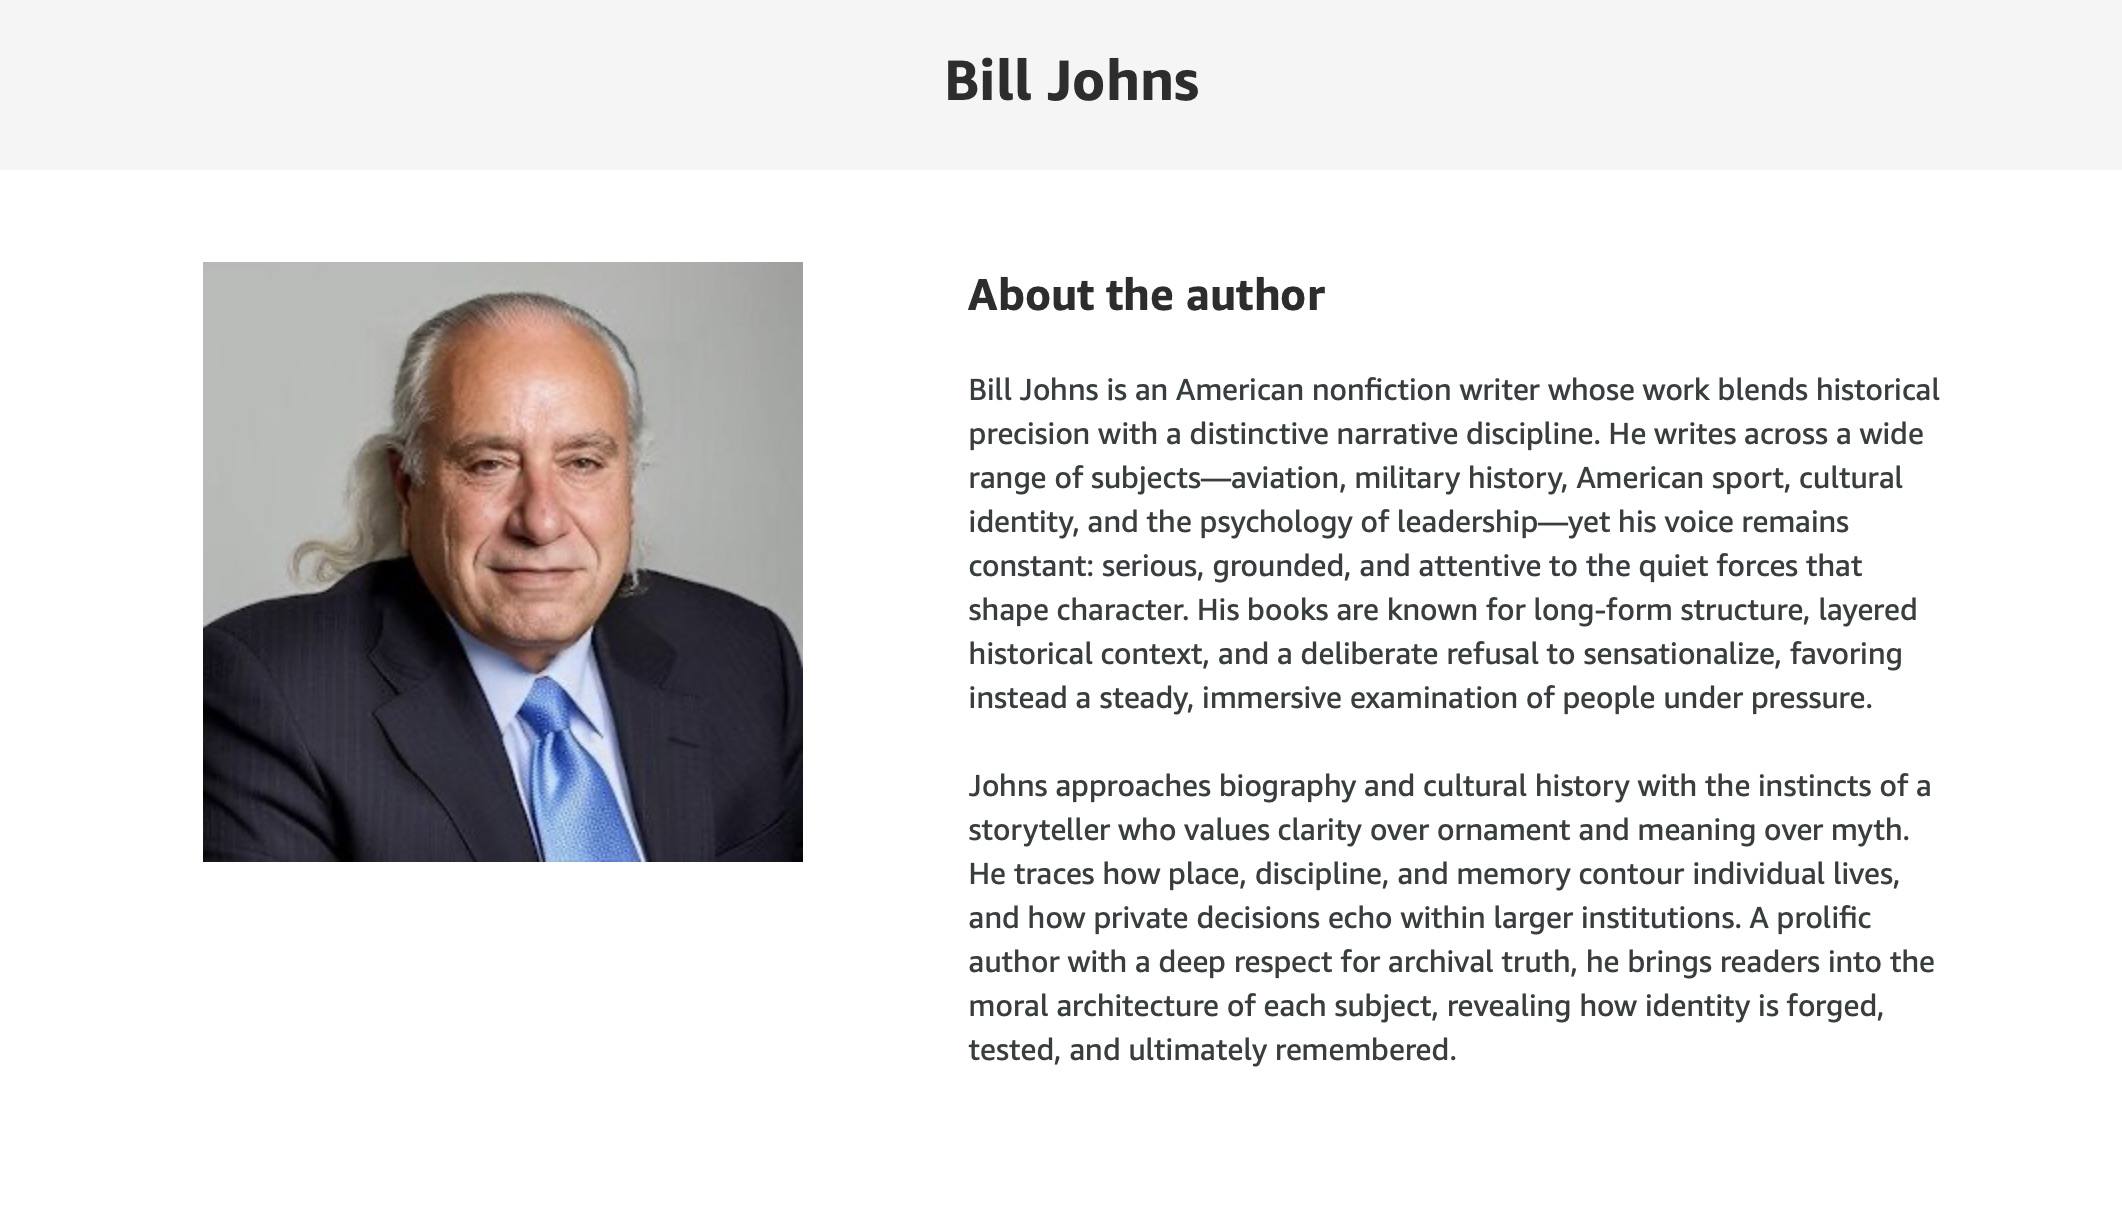
O toque final no retrato desse incansável autor de autopublicação é, bem, o próprio retrato que aparece em sua página de autor na Amazon e na contracapa de todos os seus livros. Johns não esconde que a imagem também foi gerada por IA e explica a escolha com sua praticidade e franqueza características: “Era isso ou vestir um terno e tirar selfies.”
Johns deixou a IA cuidar até da sua foto de autor. Vestir-se bem e tirar uma selfie aparentemente dava trabalho demais. Fonte
A economia do País das Maravilhas da IA: curioso, cada vez mais curioso
Qualquer leitor minimamente atento inevitavelmente se pergunta: por que Bill Johns e outros produtores de livros gerados por IA se dão a esse trabalho, e em tamanha escala? Claro, alguém poderia “escrever” um livro só para colocar o link no currículo, acrescentar com orgulho “autor na Amazon” às bios das redes sociais e contar a desconhecidos no bar que é escritor. Talvez, por garantia, produzir mais alguns. Mas por que gerar mais de 400 livros?
A resposta está no modelo econômico que a Amazon criou muito antes de a IA entrar em cena. Ao contrário das editoras tradicionais, a Amazon não imprime uma tiragem antecipadamente. A maioria dos livros publicados pelo Kindle Direct Publishing segue um modelo de impressão sob demanda: o exemplar físico só é impresso quando um cliente faz o pedido na Amazon.
É assim que um autor consegue lançar um livro praticamente sem custo inicial. E, principalmente, sem o risco de acumular em um depósito exemplares não vendidos que já foram pagos e impressos. Em outras palavras, listar centenas de livros na loja on-line custa quase nada tanto para a Amazon quanto para o autor.
Com custos de investimento próximos de zero, até uma demanda modesta pode gerar lucro real. Bill Johns, por exemplo, vende algumas centenas de livros por mês a leitores desavisados. Em uma temporada de festas de fim de ano, de dezembro ao início de janeiro, as vendas chegaram a 821 exemplares, rendendo cerca de US$ 6.000 como complemento à aposentadoria.
Alguns livros de IA rendem ainda mais dinheiro aos autores. É o caso da biografia gerada por IA do ativista político americano Charlie Kirk, que se tornou um best-seller na Amazon após seu assassinato. Os leitores não ficaram satisfeitos e, depois de dezenas de avaliações com expressões como “entorpecente”, “golpe” e “uma vergonha”, a Amazon retirou o livro da plataforma. Ainda assim, é provável que o serviço tenha vendido milhares de exemplares da biografia antes disso, gerando um lucro considerável tanto para a Amazon quanto para o autor.
Como distinguir um corvo de uma escrivaninha
Em um mundo saturado de IA, distinguir o que é feito por humanos do que é feito por máquinas é cada vez mais relevante. E a Amazon está longe de ser o único marketplace on-line que alimenta ativamente a disseminação de lixo de IA, portanto há todos os motivos para acreditar que a situação só tende a piorar.
Para evitar mais uma leva de alucinações nada inspiradoras produzidas por chatbots, recomendamos recorrer a fontes confiáveis quando o assunto realmente importa. Em matéria de conhecimento especializado sobre cibersegurança, por exemplo, nosso blog é um bom ponto de partida. Ao contrário de certos consultores aposentados superprodutivos, escrevemos tudo por conta própria e assumimos a responsabilidade por cada palavra.
Para saber mais sobre cibersegurança em livros e filmes, confira outras publicações do nosso blog:
Não é segredo que os cibercriminosos vêm usando grandes modelos de linguagem para otimizar suas operações. Como resultado, as inúmeras campanhas de phishing e malware direcionadas às organizações tornaram-se muito mais sofisticadas. Esses e-mails agora contêm menos erros evidentes, e o tom deles se aproxima muito de uma correspondência comercial legítima. No entanto, os métodos usados para distribuir essas campanhas sempre apresentam um indício claro: uma tentativa de roubar credenciais ou executar código malicioso. Os ataques de comprometimento de e-mail comercial (BEC), no entanto, representam um desafio ainda maior.
Os ataques BEC normalmente dependem inteiramente da engenharia social, induzindo um funcionário legítimo a executar as ações solicitadas pelos invasores. Esses ataques também se tornaram muito mais sofisticados desde o surgimento dos LLMs. Se as táticas forem bem-sucedidas, por exemplo, se eles conseguirem convencer um funcionário a transferir fundos para uma conta de terceiros em vez da conta de um prestador de serviços, a empresa poderá perder muito dinheiro em questão de instantes. Foi por isso que desenvolvemos uma tecnologia especializada para detectar e-mails de BEC gerados com IA.
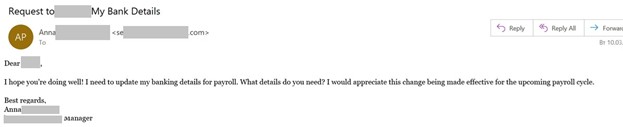
Um exemplo de um e-mail de BEC gerado por LLM.
Como funciona a tecnologia de detecção de BEC gerado com IA
Sem entrar em muitos detalhes técnicos, veja como essa nova tecnologia funciona. Como você deve saber, os grandes modelos de linguagem não produzem textos da mesma forma que os seres humanos. Em vez disso, eles preveem as palavras que têm maior probabilidade de se adequar à tarefa descrita no prompt. Além disso, os cibercriminosos tendem a seguir o caminho mais fácil: em vez de reinventar a roda, recorrem aos modelos de IA mais amplamente disponíveis.
Como o objetivo dos invasores é relativamente claro, podemos extrair do texto frases-chave específicas de ataques de BEC. Além disso, aprendemos a identificar quando um texto foi gerado por uma máquina. Esses indicadores são um dos pilares da nossa tecnologia de detecção. Como resultado, nossa solução de segurança agora consegue identificar e bloquear tentativas de ataques BEC logo no estágio inicial, antes mesmo que o invasor tenha a oportunidade de enganar um funcionário. Atualmente, a tecnologia detecta e-mails de BEC gerados com IA em inglês, russo, alemão, francês, italiano, espanhol, português e turco.
Quais de nossas soluções apresentam a tecnologia de detecção de BEC gerada com IA?
Nosso portfólio de soluções de segurança corporativa inclui o Kaspersky Security for Mail Server, que incorpora o Kaspersky Secure Mail Gateway. É no gateway seguro de e-mail que nossa tecnologia de detecção de e-mails BEC gerados por IA está implementada. Mais especificamente, o recurso está disponível na licença KSMS Plus após a recente atualização para o KSMG 3.1. Visite a página oficial do Kaspersky Secure Mail Serverpara saber mais sobre nossas soluções de segurança de e-mail e os recursos adicionados na atualização mais recente.
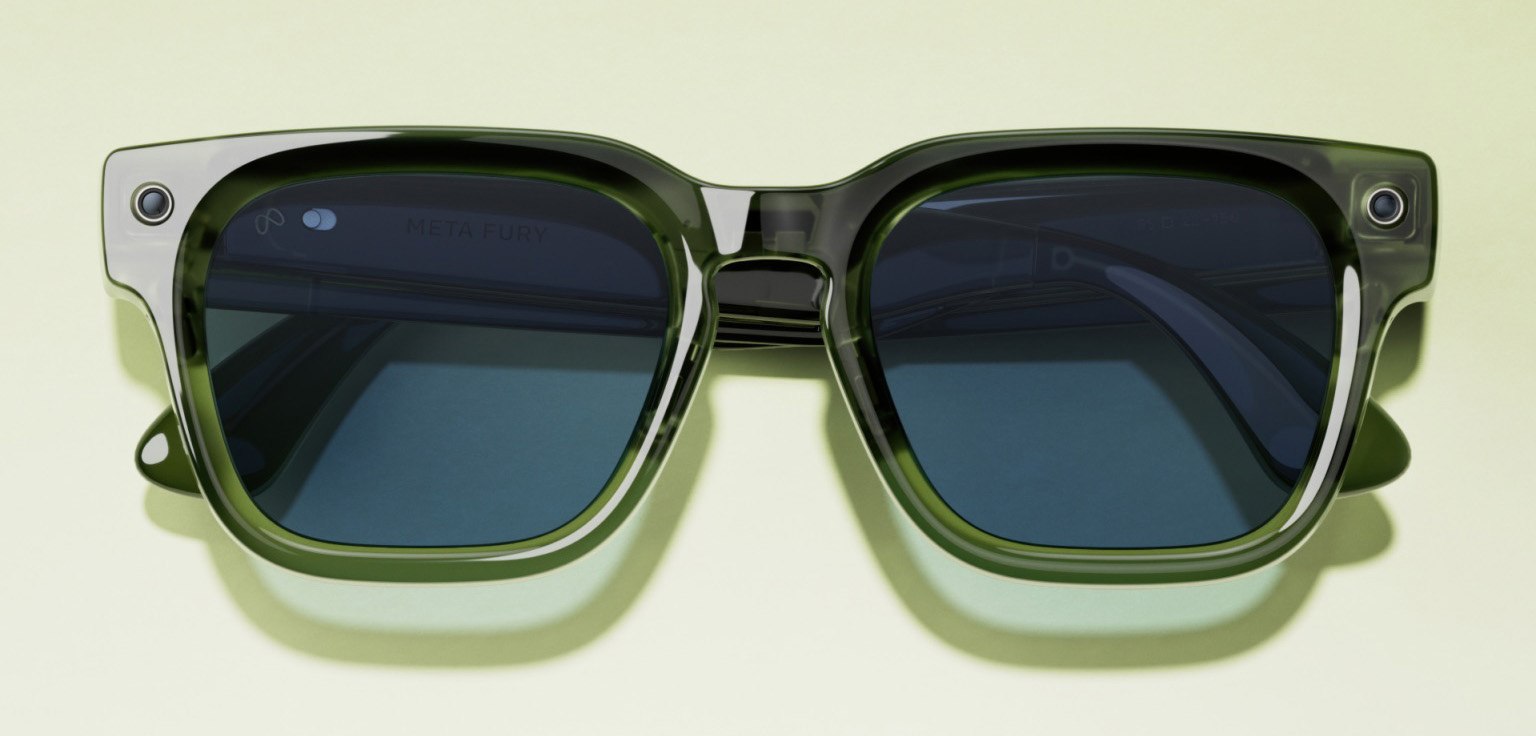
As gigantes da tecnologia estão apostando mais uma vez nos óculos inteligentes. A ideia há muito tempo fascina escritores de ficção científica e seus maiores entusiastas: os habitantes do Vale do Silício. Muitos ainda se lembram do Google Glass, a primeira tentativa concreta de criar um dispositivo desse tipo, lançada em 2012. O projeto acabou entrando para a história como um dos poucos grandes fracassos do Google.
Após o fracasso retumbante do Google, outras gigantes da tecnologia, como Meta, Apple e Microsoft, deixaram de lado a ideia de óculos elegantes e leves para concentrar seus esforços em headsets de realidade virtual mais robustos. Um dos principais motivos para essa mudança foi que a tecnologia disponível na década de 2010 ainda não era suficientemente avançada para oferecer recursos de alto desempenho e uma boa autonomia de bateria em um par de óculos compacto.
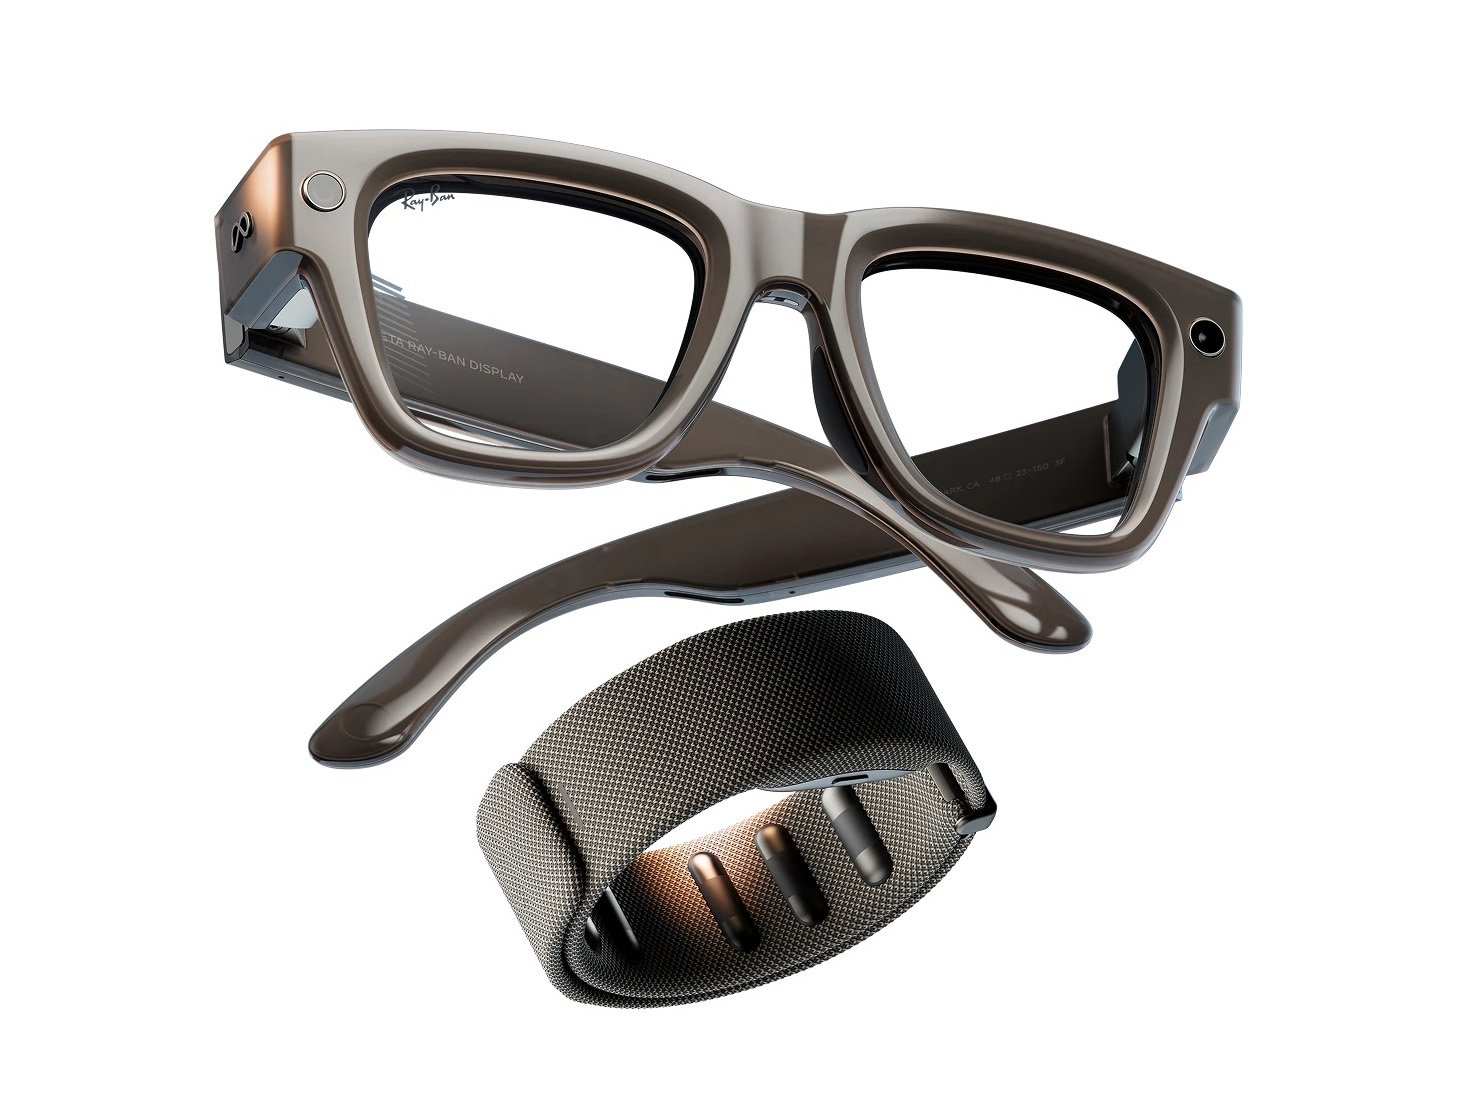
Por enquanto, porém, a parceria entre a Ray-Ban e a Meta é a líder incontestável do mercado. Em 2025, as empresas lançaram seus óculos inteligentes mais avançados, vendendo mais de 7 milhões de unidades somente naquele ano.
No entanto, desde o início de 2026, os óculos Ray-Ban Meta vêm sendo alvo de uma série de polêmicas negativas. Todas giram em torno de um recurso que permitiria à câmera dos óculos reconhecer rostos em seu campo de visão. Quando ativado, o sistema notificaria o usuário sempre que identificasse uma pessoa.
O que são exatamente os óculos Ray-Ban Meta?
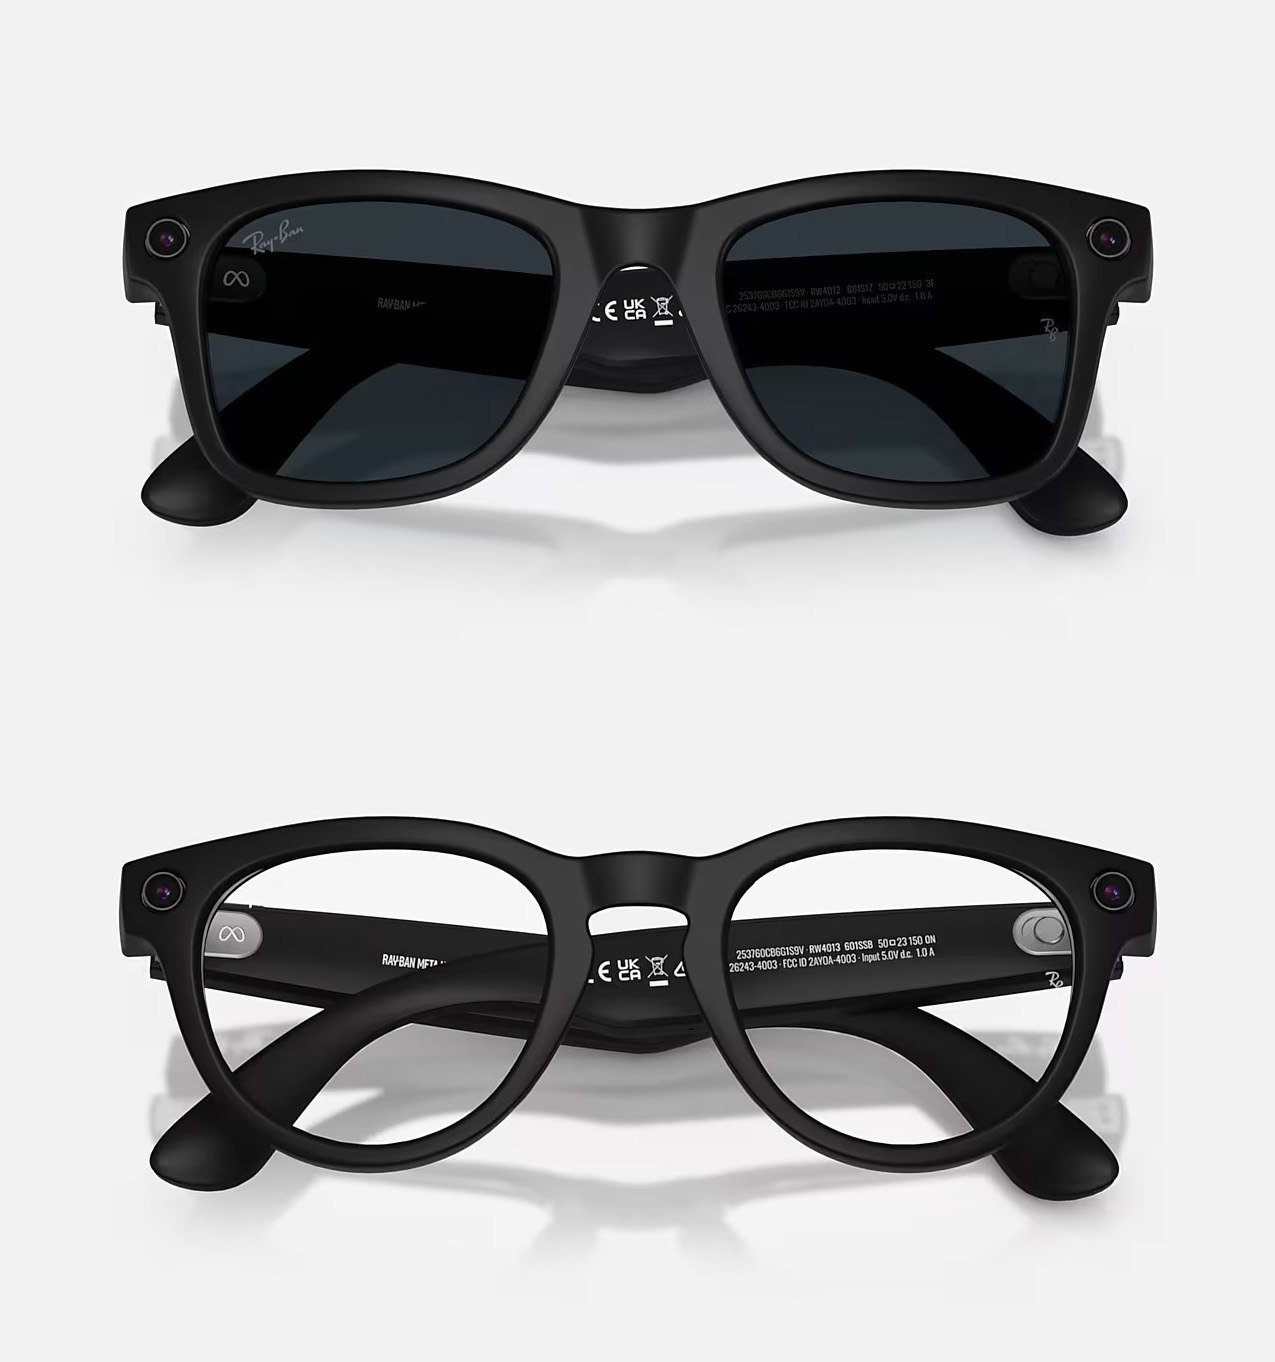
A Ray-Ban e a Meta uniram forças pela primeira vez em 2020. Na época, esses óculos elegantes e de alta tecnologia foram concebidos como um complemento para o Metaverso, o ambicioso projeto de realidade virtual de Mark Zuckerberg. No fim das contas, porém, os óculos sobreviveram ao projeto para o qual foram criados. Mas não vamos jogar mais sal na ferida de Zuckerberg. Em 2021, Ray-Ban e Meta lançaram sua primeira colaboração: os Ray-Ban Stories. Dois anos depois, a nova geração chegou ao mercado com um nome mais simples: Ray-Ban Meta. Em 2025, o próprio Mark Zuckerberg apresentou os Ray-Ban Meta Gen 2, equipados com inteligência artificial. É essa versão que vamos analisar.
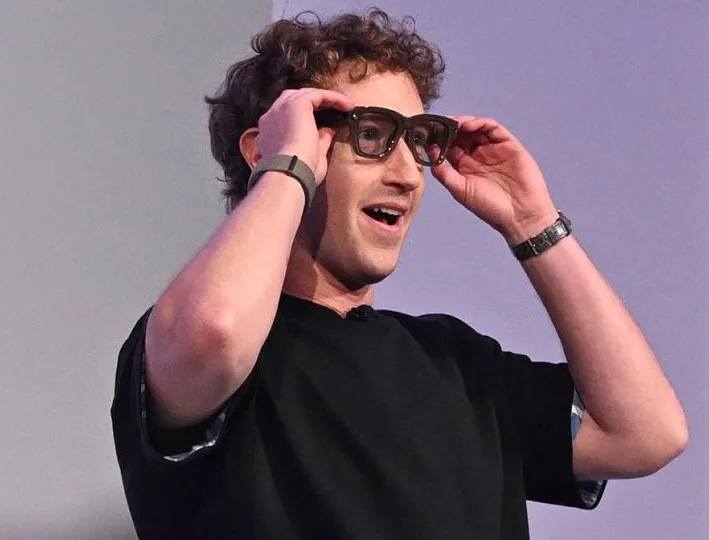
Mark Zuckerberg usando os óculos Meta Ray-Ban Display durante a apresentação dos Ray-Ban Meta Gen 2, em 2025. Fonte
Diferentemente dos primeiros Ray-Ban Meta, a geração Gen 2 foi posicionada como um dispositivo voltado para atividades físicas e para o uso cotidiano. Inicialmente, as empresas ofereceram dois modelos de armação, Wayfarer e Headliner, disponíveis em várias cores. As lentes estão disponíveis nas versões transparentes, escuras (para óculos de sol) ou fotocromáticas. Também era possível adquirir lentes de grau mediante pagamento adicional.
No lançamento, os Ray-Ban Meta estavam disponíveis em dois estilos de armação: Wayfarer (acima) e Headliner (abaixo). Source 1 and Source 2
Posteriormente, a Meta ampliou a linha com novas opções de armação, incluindo os Oakley Meta HSTN e Oakley Meta Vanguard (a Oakley é outra marca de óculos pertencente à EssilorLuxottica, a mesma empresa controladora da Ray-Ban). Independentemente do modelo da armação, todos esses dispositivos reúnem o mesmo conjunto de funcionalidades principais:
Captura de fotos e vídeos em primeira pessoa
Reprodução de músicas, podcasts e outros conteúdos de áudio
Realização de chamadas telefônicas
Envio e recebimento de mensagens usando comandos de voz
Tradução de fala em tempo real, com suporte a diversos idiomas
Conversão de fala em texto
Leitura em voz alta de notificações e mensagens
Criação de notas de voz e lembretes
Transmissão de vídeo em primeira pessoa durante chamadas de vídeo do WhatsApp e do Messenger
Navegação em mapas com orientações por voz
Respostas a perguntas do usuário sobre o ambiente ao redor e os objetos em seu campo de visão
Os óculos inteligentes da Meta funcionam por meio de vários componentes integrados. Em primeiro lugar, contam com uma câmera capaz de capturar fotos e gravar vídeos exatamente a partir da linha de visão do usuário. Em segundo lugar, as hastes abrigam alto-falantes abertos (open-ear). Eles permitem ouvir músicas, receber orientações de navegação, atender chamadas e escutar as respostas da Meta AI sem bloquear os sons ao redor com fones intra-auriculares, uma vantagem discutível para quem valoriza a privacidade do áudio.
Por fim, os óculos possuem vários microfones integrados, utilizados para chamadas telefônicas, reconhecimento de comandos de voz e interação com o assistente de inteligência artificial. O que a maioria dos óculos inteligentes da Meta não possui, entretanto, é uma tela. Apenas o modelo mais caro e avançado da linha, o Meta Ray-Ban Display, conta com um visor integrado.
Todas as fotos e vídeos capturados pela câmera dos óculos, bem como as configurações do dispositivo, são armazenados no aplicativo complementar Meta AI, que sincroniza os óculos com um smartphone. É justamente a combinação entre câmera, microfones, alto-falantes e o aplicativo Meta AI que permite ao dispositivo analisar o ambiente ao redor e responder, em tempo real, às solicitações do usuário.
Em comparação com dispositivos como o Apple Vision Pro, os dispositivos da Meta são relativamente acessíveis, custando cerca de US$ 400 a US$ 500. Além disso, a empresa lançou recentemente uma nova linha sob sua própria marca, chamada Meta Glasses, com preço inicial de US$ 299. Com preços nessa faixa, a possibilidade de esses dispositivos se tornarem populares em larga escala deixou de ser ficção científica.
É justamente por isso que os relatos sobre o recurso NameTag são ainda mais alarmantes. Segundo jornalistas e pesquisadores, essa funcionalidade foi projetada para reconhecer pessoas que entram no campo de visão da câmera dos óculos. Vamos entender melhor como isso funciona.
NameTag: o recurso que “não existe”
Informações vazadas de documentos internos da Meta sobre o desenvolvimento de um recurso de reconhecimento facial para os óculos inteligentes da empresa vieram a público, por uma coincidência sinistra, na sexta-feira, 13 de fevereiro de 2026. Os documentos revelam que o recurso, chamado internamente de NameTag, utilizaria o assistente de inteligência artificial integrado da Meta para identificar pessoas capturadas pelo campo de visão da câmera dos óculos e fornecer ao proprietário do dispositivo informações sobre elas.
De acordo com o vazamento, a Meta avaliou duas formas de operar o NameTag. A primeira permitiria reconhecer apenas pessoas que já fazem parte dos contatos existentes do usuário nos serviços da Meta. A segunda seria muito mais abrangente, possibilitando identificar qualquer pessoa com um perfil público nas plataformas sociais da empresa: Instagram, Facebook e, potencialmente, WhatsApp e Messenger.
Os Oakley Meta HSTN, um dos modelos de óculos inteligentes da linha, a partir de US$ 399. Source
Se tudo isso causa arrepios, não se preocupe. A gigante da tecnologia, conhecida por seu compromisso “supostamente inabalável” com a privacidade dos usuários, foi rápida em divulgar uma declaração tranquilizadora:
“Nossos concorrentes oferecem esse tipo de produto com reconhecimento facial; nós não oferecemos. Se algum dia lançarmos um recurso desse tipo, adotaremos uma abordagem muito cuidadosa antes de disponibilizá-lo ao público”.
A prova dessa abordagem supostamente cuidadosa surgiu apenas alguns meses depois. Em junho de 2026, a Wired informou que a Meta havia incorporado discretamente a tecnologia de reconhecimento facial dos seus óculos inteligentes ao aplicativo Meta AI. Segundo os jornalistas, o código foi sendo inserido aos poucos no software ao longo de vários meses, a partir de janeiro de 2026.
Como funciona o recurso que supostamente não existe
Quando a reportagem investigativa foi publicada, o NameTag ainda não estava disponível para os usuários. No entanto, de acordo com a Wired, o código necessário para fazê-lo funcionar já estava presente no aplicativo complementar Meta AI, utilizado pelos proprietários dos óculos inteligentes da empresa e instalado em mais de 50 milhões de smartphones.
O NameTag utiliza três modelos de inteligência artificial para realizar essa tarefa.
O primeiro detecta rostos no campo de visão da câmera.
O segundo isola e recorta esses rostos.
O terceiro converte esses rostos em impressões biométricas únicas.
Segundo a Wired, os três modelos já haviam sido baixados dos servidores da Meta e estavam armazenados nos dispositivos dos usuários. Após o lançamento oficial do recurso, o aplicativo utilizaria essa impressão biométrica para compará-la com um banco de dados de impressões semelhantes armazenado no smartphone do proprietário dos óculos.
Além disso, os jornalistas afirmam que esse banco de dados já estava configurado para buscar atualizações em tempo real da Meta. É plausível imaginar que esse banco de dados pudesse ser criado a partir de perfis públicos nas plataformas da Meta, incluindo fotos que os próprios usuários enviam ao Instagram e ao Facebook. Por enquanto, porém, isso é apenas uma hipótese. Como o recurso oficialmente “não existe”, a Meta não explicou publicamente como esses perfis seriam criados.
Quando uma correspondência fosse encontrada, o sistema notificaria o usuário de que uma pessoa havia sido identificada. No entanto, a tecnologia não simplesmente ignoraria os rostos que não conseguisse identificar. Essas imagens seriam automaticamente recortadas, indexadas e armazenadas em uma pasta separada chamada “Pending” (“Pendente”).
Alguns elementos da interface do aplicativo Meta AI, relacionados ao NameTag, foram implementados e ficaram acessíveis aos usuários na atualização de maio de 2026. Nessa versão, o recurso recebeu o nome muito mais brando de “Connections” (“Conexões”). Segundo sua descrição, ele foi criado para ajudar os usuários a “lembrar das pessoas que encontraram”.
Os Oakley Meta Vanguard, um dos modelos mais caros da linha de óculos inteligentes. Os preços começam em torno de US$ 499. Source
É evidente essa tecnologia é um prato cheio para perseguidores, golpistas, pessoas mal-intencionadas e interessados em desenterrar informações comprometedoras sobre desconhecidos. Bastaria um simples olhar para revelar a identidade digital de alguém e todos os dados associados a ela.
As implicações para a privacidade são ainda mais amplas. A possibilidade de permanecer anônimo entre desconhecidos sempre foi considerada algo natural. Tecnologias como o NameTag nos aproximam de uma realidade de vitrine permanente, na qual o rosto se torna um identificador universal e qualquer encontro casual pode desencadear uma verificação instantânea de antecedentes digitais.
Dar acesso em massa a esse tipo de tecnologia é exatamente o tipo de ideia genial que se esperaria desses tech bros que ainda não conseguem fazer ninguém conversar com eles em um bar. Felizmente, a revelação da existência do NameTag e a reação negativa da opinião pública fizeram com que o código responsável pelo recurso desaparecesse da versão mais recente do aplicativo. Pelo menos, por enquanto.
O recurso desapareceu, mas as perguntas continuam
No dia seguinte à publicação da reportagem da Wired, a Meta lançou uma nova versão do aplicativo, removendo praticamente todo o código relacionado ao NameTag. O vice-presidente de Comunicação da empresa, Andy Stone, reforçou a posição oficial, afirmando que os jornalistas deveriam desconsiderar as evidências de que tal funcionalidade existia. Enquanto isso, especialistas em privacidade alertaram que a Meta poderia restaurar o código do NameTag nos aplicativos dos usuários com a mesma facilidade com que o removeu. Ainda é cedo demais para baixar a guarda.
O Meta Fury é um dos modelos da nova linha Meta Glasses, com preço inicial de US$ 299. Diferentemente da maioria dos dispositivos anteriores da empresa, esses óculos são comercializados diretamente sob a marca Meta. Source
Algumas semanas depois, a Wired publicou outra reportagem reveladora sobre o NameTag e o reconhecimento facial. Os jornalistas conseguiram obter um contrato de licenciamento firmado entre a Meta e a Rank One Computing, empresa especializada em tecnologias de reconhecimento facial para órgãos policiais e agências militares dos Estados Unidos. Segundo a reportagem, entre seus clientes estariam o Naval Criminal Investigative Service (NCIS), o U.S. Special Operations Command (USSOCOM) e diversos departamentos de polícia.
A Meta adquiriu os direitos de uso da tecnologia de reconhecimento facial da Rank One Computing, incluindo seu sistema de “detecção de presença real”, capaz de distinguir uma pessoa real de uma fotografia, vídeo ou máscara. De acordo com os termos do contrato, o software pode operar com um banco de dados de até 10 milhões de perfis biométricos. Antes da remoção do NameTag, a Wired informou que a tecnologia de reconhecimento facial da Rank One Computing e seus componentes de software já estavam integrados ao aplicativo Meta AI, embora permanecessem inativos e indisponíveis aos usuários.
Há anos, o uso de tecnologias de reconhecimento facial por órgãos de segurança pública desperta intensos debates sobre os limites aceitáveis da vigilância. Por isso, a perspectiva de capacidades semelhantes chegarem a um dispositivo de consumo que qualquer pessoa possa comprar e utilizar é, para dizer o mínimo, controversa, especialmente quando ele pode associar o rosto de um desconhecido qualquer aos seus perfis digitais. Tanto a Meta quanto a Rank One Computing se recusaram a comentar a parceria.
O Meta Ray-Ban Display, o único modelo da linha equipado com câmera e visor integrado. Source
Como preservar o que resta da sua privacidade em um mundo distópico
A ideia de que tecnologias militares estejam sendo incorporadas a dispositivos de consumo já é suficiente para causar arrepios em qualquer pessoa. Infelizmente, precisamos encarar a realidade: proteger-se de óculos capazes de realizar reconhecimento facial será uma tarefa bastante difícil. Mas isso não significa que você não deva tentar.
O Nearby Glasses detecta os óculos da Meta e da Snap identificando os sinais Bluetooth que esses dispositivos transmitem para se comunicar com outros dispositivos. Evidentemente, esse método não é infalível e pode gerar alguns falsos positivos. Ainda assim, o aplicativo oferece um alerta útil de que pode haver, nas proximidades, um dispositivo capaz de gravar você discretamente e verificar o ambiente ao seu redor.
O aplicativo Nearby Glasses alerta os usuários sobre a presença de óculos inteligentes da Meta ou da Snap nas proximidades ao detectar os sinais Bluetooth emitidos por esses dispositivos. Source
Se você está especialmente preocupado com sua privacidade, instalar um aplicativo como esse é uma medida sensata. Ele pode ser especialmente útil para pessoas que pertencem a grupos mais vulneráveis, como vítimas de perseguição, profissionais do sexo ou imigrantes em situação irregular.
Para quem ainda não está pronto para adotar uma postura totalmente paranoica, recomendamos configurar suas contas da Meta como privadas. É verdade que isso não impedirá que os óculos inteligentes capturem seu rosto, nem representa uma proteção absoluta contra um eventual reconhecimento facial. No entanto, restringir o acesso às suas fotos, listas de contatos e outras informações pessoais reduz a quantidade de dados que poderiam ser usados para identificá-lo e traçar seu rastro digital.
Se você não tiver certeza de quão fortes são as configurações de segurança das suas redes sociais, recomendamos verificar nossa ferramenta on-line gratuita – a Privacy Checker. Ela oferece um passo a passo para ajustar as configurações de privacidade e segurança em redes sociais e plataformas digitais, ajudando a reduzir a quantidade de informações pessoais expostas online para que desconhecidos vejam.
A Copa do Mundo de 2026 é um dos eventos de futebol mais aguardados do ano. O torneio será sediado em três países: EUA, Canadá e México. Infelizmente, eventos desse porte atraem não apenas torcedores, mas também golpistas de todo o mundo. Já revelamos como os cibercriminosos estão se preparando para a Copa do Mundo e hoje estamos falando sobre segurança digital para os torcedores no México.
O país sediará 13 partidas e receberá milhões de turistas. Eles ficarão hospedados em hotéis, assistirão a jogos, frequentarão restaurantes, transitarão por aeroportos e visitarão pontos turísticos populares, e em todos os lugares que forem, a tentação de se conectar a redes Wi-Fi públicas será grande.
Avaliamos mais de 84.500 (!) pontos de acesso Wi-Fi públicos na Cidade do México, em Guadalajara e em Monterrey, e temos muitas informações para compartilhar sobre a segurança deles. Alerta de spoiler: muitas redes ainda usam padrões de segurança desatualizados, então, você realmente não deve sair de férias sem proteção confiável e um eSIM.
O que foi testado e de que forma
Percorrer o México a pé à procura de pontos de acesso Wi-Fi públicos teria sido um pouco complicado, embora tenha sido exatamente isso que fizemos num estudo semelhante sobre a segurança de redes Wi-Fi em Paris. Você pode conferir os resultados desse estudo na postagem Como é a segurança das redes Wi-Fi em Paris?
Dessa vez, a missão era muito mais desafiadora: mapear o cenário de redes sem fio de três grandes metrópoles. Foi por isso que recorremos ao wardriving, ou seja, usamos um smartphone ou notebook para buscar e registrar redes sem fio de dentro de um veículo em movimento. Isso é parecido com o que seu telefone faz ao procurar redes Wi-Fi próximas constantemente. Porém, em vez de nos conectarmos a elas, apenas coletamos dados.
Todas as informações foram estritamente usadas para observação passiva e análise de infraestrutura. Os especialistas da Equipe de Pesquisa e Análise Global da Kaspersky (GReAT) coletaram apenas informações de serviço transmitidas publicamente. Não houve tentativas de autenticação, interceptação de tráfego, exploração de sistemas ou interação com as redes sem fio detectadas. Os pontos de acesso móveis implementados em carros e em dispositivos móveis foram excluídos da amostra.
Nosso principal alvo era a Cidade do México, a capital do país e uma das cidades com maior densidade demográfica da América Latina. Percorremos de carro alguns dos pontos turísticos mais populares da cidade: Estádio da Cidade do México, Aeroporto Internacional, Zócalo, Paseo de la Reforma, Colonia Roma, La Condesa, Polanco e Coyoacán.
Percorremos rotas semelhantes em Guadalajara e Monterrey: estádios, avenidas principais, aeroportos e bairros populares. Abaixo, é possível ver um mapa de calor das áreas que percorremos. As regiões em vermelho representam as áreas de maior densidade de pontos de acesso público, passando pelas regiões em amarelo e verde, até chegar nas azuis, que representam a concentração mais baixa.
Mapa de calor mostrando a localização de todos os pontos de acesso Wi-Fi encontrados na Cidade do México
Mapa de calor mostrando a localização de todos os pontos de acesso Wi-Fi encontrados em Guadalajara
Mapa de calor mostrando a localização de todos os pontos de acesso Wi-Fi encontrados em Monterrey
Usamos reconhecimento passivo por rádio para registrar 84.500 sinais e 69.500 identificadores de rede exclusivos nessas três cidades. A maioria dos sinais foi captada na Cidade do México (61,4%), seguida por Guadalajara (23,6%) e Monterrey (14,8%).
O que analisamos:
Identificadores de rede sem fio (SSIDs): os nomes que aparecem na lista de redes Wi-Fi disponíveis
Informações obtidas desses identificadores
Configurações padrão do roteador e como os ISPs implementam suas redes
Frequências usadas e características do sinal
Carga dos canais e uso do espectro de radiofrequência
Configurações de segurança das redes sem fio:
Redes abertas e inseguras
Redes com WPS ativado
Redes seguras (WPA2/WPA3) com WPS ativado
Você pode encontrar a versão completa do estudo no blog Securelist.
Nomes de pontos de acesso Wi-Fi públicos reveladores
Os nomes das redes (SSIDs) podem revelar muitas informações de forma involuntária sobre os fabricantes do hardware, ISPs e métodos de implementação, além de revelar se um ponto de acesso pertence a uma empresa ou a um usuário.
Cerca de 34% das redes Wi-Fi públicas registradas nem sequer alteraram seus nomes, mantendo os SSIDs originais dos fabricantes dos roteadores ou usando convenções de nomenclatura padrão dos seus ISPs. Essa pode ser uma informação bastante útil para atacantes, pois esse tipo de nome de rede permite que eles saibam qual ponto de acesso pertence a determinado provedor, qual hardware está sendo usado e a sua configuração padrão provável.
Outro fato preocupante é o grande número de redes Wi-Fi (mais de 30%) que usam o endereço MAC do ponto de acesso (BSSID) como nome da rede visível. Os primeiros bytes de um BSSID contêm um Identificador organizacional único (OUI) que revela quem é o fabricante do roteador. Essa é uma informação útil para pessoas mal-intencionadas: elas podem descobrir quem fabricou o hardware e testar vulnerabilidades específicas relativas aos modelos dessa marca.
O Wi-Fi do México está bem protegido?
Pode-se considerar que um ponto de acesso protegido com WPA2/WPA3 está mais ou menos seguro. Todos os outros mecanismos de autenticação produzem resultados muito mais fracos. Agrupamos as redes Wi-Fi públicas em quatro categorias:
Seguras (WPA2/WPA3)
Inseguras (abertas/WEP)
Fracas (WPA)
Indeterminadas
Os resultados obtidos nas três cidades são muito parecidos: cerca de 82% de todos os pontos de acesso analisados estão protegidos por padrões seguros. O protocolo WPA, que é inseguro e está desatualizado, quase não é utilizado. No entanto, mais de 10% dos pontos de acesso são completamente inseguros. Quem se conecta a essas redes corre o risco de ser vítima de interceptação de tráfego e vigilância oculta.
Mas a segurança não é avaliada apenas pelos protocolos WPA. Também verificamos a presença do WPS, o conhecido recurso que possibilita a conexão rápida a uma rede sem necessidade de senha e que é altamente vulnerável a ataques. Descobriu-se que o WPS está ativado em 47% dos pontos de acesso na Cidade do México (quase a metade), 43% em Guadalajara e 41% em Monterrey. Em média, 45% dos pontos de acesso são potencialmente vulneráveis a ataques relacionados ao WPS, o que representa um sacrifício à segurança em nome da conveniência.
Além disso, esse recurso permaneceu ativo com frequência até mesmo em redes WPA2/WPA3 aparentemente seguras (cerca de metade delas utilizava WPS). Isso mostra que, para que um ponto de acesso Wi-Fi seja considerado seguro, não basta ter WPA2/WPA3, pois recursos adicionais, como o WPS, ainda podem viabilizar ataques.
O que mais os turistas precisam saber
Os riscos digitais em uma viagem não se limitam apenas a redes Wi-Fi públicas, especialmente porque muitas pessoas estão migrando do Wi-Fi público para um eSIM. Ainda há muitas ameaças em lugares com grande movimentação de pessoas: carregadores USB públicos, códigos QR com links trocados, ataques por meio de NFC e Bluetooth e, é claro, táticas de engenharia social. Vamos nos aprofundar em cada um desses fatores.
Estações de carregamento. Os carregadores USB públicos também podem ser perigosos: pessoas mal-intencionadas podem obter acesso aos dados no seu dispositivo ou tentar instalar um malware. Detalhamos esses ataques na nossa postagem Roubo de dados durante o carregamento do smartphone.
Códigos QR perigosos. Os criminosos podem disseminar códigos QR contendo phishing em pontos turísticos populares. Os pretextos podem variar bastante; por exemplo, anúncios de “eventos” para torcedores de um time específico ou links que supostamente oferecem descontos ou exibem cardápios de restaurantes. Na realidade, qualquer código QR postado na rua pode ser considerado inseguro por padrão, e você não deve utilizar seu smartphone para lê-los, a menos que tenha um Analisador de ameaças de códigos QR instalado.
Transmissões, ingressos e bolões falsos. Em postagens anteriores, descrevemos casos em que pessoas mal-intencionadas estavam distribuindo malware por meio de aplicativos IPTV falsos para aproveitar da empolgação em torno da Copa do Mundo de 2026. Lembre-se, mesmo que você planeje assistir aos jogos em casa, ainda precisa ficar alerta e não confiar em qualquer site que anuncie transmissões gratuitas, ofereça bolões ou prometa pagamentos bastante generosos.
Apesar da prevalência de pontos de acesso Wi-Fi públicos WPA2/WPA3 seguros na Cidade do México, em Guadalajara e em Monterrey, nosso estudo mostra que as redes Wi-Fi públicas continuam vulneráveis. Também é importante lembrar que os invasores podem criar redes falsas (as chamadas gêmeas do mal) disfarçadas de redes Wi-Fi públicas legítimas em aeroportos, hotéis, cafeterias e pontos turísticos.
É quase impossível para um usuário comum dizer o quanto um ponto de acesso específico é seguro ao tentar se conectar a ele. É por isso que a opção mais segura é usar dados móveis para acessar a Internet, eliminando por completo a necessidade de Wi-Fi. Além disso, não há necessidade de pesquisar as leis locais, tarifas e outras informações relativas a redes móveis para cada país que você planeja visitar. Basta comprar um cartão eSIM global on-line em dois cliques. Explicamos como facilitar todo esse processo na postagem Internet móvel com a Kaspersky eSIM Store.
Se você ainda planeja usar uma rede Wi-Fi pública, sempre use uma VPN para proteger seu dispositivo e dados ao se conectar a redes Wi-Fi desconhecidas e desprotegidas. Isso cria um túnel criptografado entre o seu dispositivo e o servidor VPN, impossibilitando a interceptação dos seus dados ao longo do caminho. Ainda não escolheu uma VPN? Experimente a Kaspersky Secure Connection, que está incluída nas assinaturas do Kaspersky Premium e do Kaspersky Plus.
Agora, se você ainda planeja participar da Copa do Mundo sem nenhuma solução de segurança cibernética, pelo menos siga estas regras básicas de higiene digital:
Não use carregadores USB públicos
Não envie informações confidenciais por conexões que não são seguras
Não faça login em contas bancárias, e-mail ou redes sociais por meio de redes Wi-Fi inseguras
Desative o Bluetooth e o NFC ao frequentar lugares com grande movimentação de pessoas
Não confie nos códigos QR postados na rua
Somente se conecte a um Wi-Fi público quando for absolutamente necessário
Leia também os seguintes artigos e garanta que torcer pelo seu time favorito não seja apenas emocionante, mas também seguro:

 Entrar